Robots.txt e IA: la línea común para que OpenAI, Google, Microsoft y Anthropic no entrenen con tu web
Desde el 30 de octubre de 2026, OpenAI, Google, Microsoft y Anthropic dicen que respetarán una misma línea de robots.txt para que una web pida no usarse en el entrenamiento de modelos de IA. Es una preferencia, no un candado, y todavía no funciona en ninguna de las cuatro del todo: aquí está cómo se escribe, cuándo empieza a contar y qué decidir antes de tocarla.
¿Qué han acordado OpenAI, Google, Microsoft y Anthropic?
Han acordado leer la misma línea de robots.txt para saber si una web quiere que su contenido se use para entrenar modelos de IA. Hasta ahora cada empresa tenía su propio rastreador o su propia etiqueta, y quien quería decir que no tenía que escribir una regla para cada una. Con la línea común basta con escribirla una vez.
- robots.txt
- El archivo de texto en la raíz de una web (tuweb.com/robots.txt) donde se dice a los rastreadores qué partes pueden visitar. Su formato está fijado en el RFC 9309.
- __usage_ai-training
- Un «token de política»: se escribe donde iría el nombre de un rastreador, pero no es ningún rastreador. Sirve para decir qué partes de la web no quieres que se usen para entrenar IA.
- Entrenar un modelo
- Usar textos, imágenes u otros contenidos para ajustar los parámetros de un modelo de IA generativa. El vocabulario de la IETF lo define así y deja fuera los modelos que no generan contenido.
Por qué importa: los modelos de lenguaje aprenden de enormes cantidades de texto, buena parte sacado de la web, y es lo que explico en la lección sobre cómo funciona la IA generativa. Para un medio, una editorial o una empresa con contenido de pago, decidir si ese contenido entra o no en el entrenamiento es una decisión de negocio, y hasta ahora era difícil expresarla de forma clara para todos a la vez.
Los cuatro anuncios llegaron el viernes 30 de octubre de 2026: Google en su blog para webmasters, Microsoft en el blog de Bing, OpenAI en su web y Anthropic a través de Kevin Kelley, autor del borrador, en la lista de correo de la IETF.
¿Cómo se escribe la línea en robots.txt?
Se escribe como un grupo normal de robots.txt cuyo User-Agent es el token. Las reglas Disallow marcan lo que no quieres que se use para entrenar y las Allow, lo que sí. Este es el ejemplo del propio borrador:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Con esas tres líneas la web pide que no se use nada para entrenar, salvo la carpeta de prensa. No hay directivas nuevas ni otra sintaxis: se aprovechan las reglas de rutas que ya conoce cualquier rastreador.
Hay tres detalles que conviene tener claros antes de copiarlo:
- Las reglas generales no cuentan. El borrador dice que un grupo con User-Agent: * nunca se aplica al token. Si tu robots.txt no tiene un grupo propio para __usage_ai-training, no expresa ninguna preferencia sobre el entrenamiento, ni a favor ni en contra.
- No es una regla de rastreo. El borrador lo dice de forma literal: no es una directiva sobre cómo rastrear. Un buscador puede seguir visitando tu web; lo que cambia es para qué puede usar lo que lee.
- Los acuerdos privados mandan. Si una web firma una licencia con una empresa de IA, ese acuerdo puede pasar por encima de lo que diga robots.txt.
Microsoft añade una opción por página, para quien quiera afinar más: una metaetiqueta <meta name="Bingbot" content="ai-training:disallow"> o la cabecera HTTP equivalente, que manda sobre robots.txt en esa página concreta.
¿Cuándo empieza a funcionar con cada empresa?
Todavía con ninguna del todo. Anthropic es la única que dice haber empezado, y avisa de que llevará tiempo extenderlo a todos sus servicios. Las otras tres han dado plazos que van de «los próximos meses» a marzo de 2027.
Quién respetará la línea común y cuándo
Lo anunciado por cada empresa el 30 de octubre de 2026
| Empresa | Cuándo | Control que ya existe para el entrenamiento |
|---|---|---|
| Anthropic | Ya ha empezado a implantarlo, de forma gradual | Bloquear ClaudeBot |
| OpenAI | En los próximos meses | Bloquear GPTBot |
| En 2027; lo leerá como si bloquearas Google-Extended | Bloquear Google-Extended | |
| Microsoft | Desde el 1 de febrero de 2027 | NoArchive y NoCache, que dejan de valer para esto el 1 de marzo de 2027 |
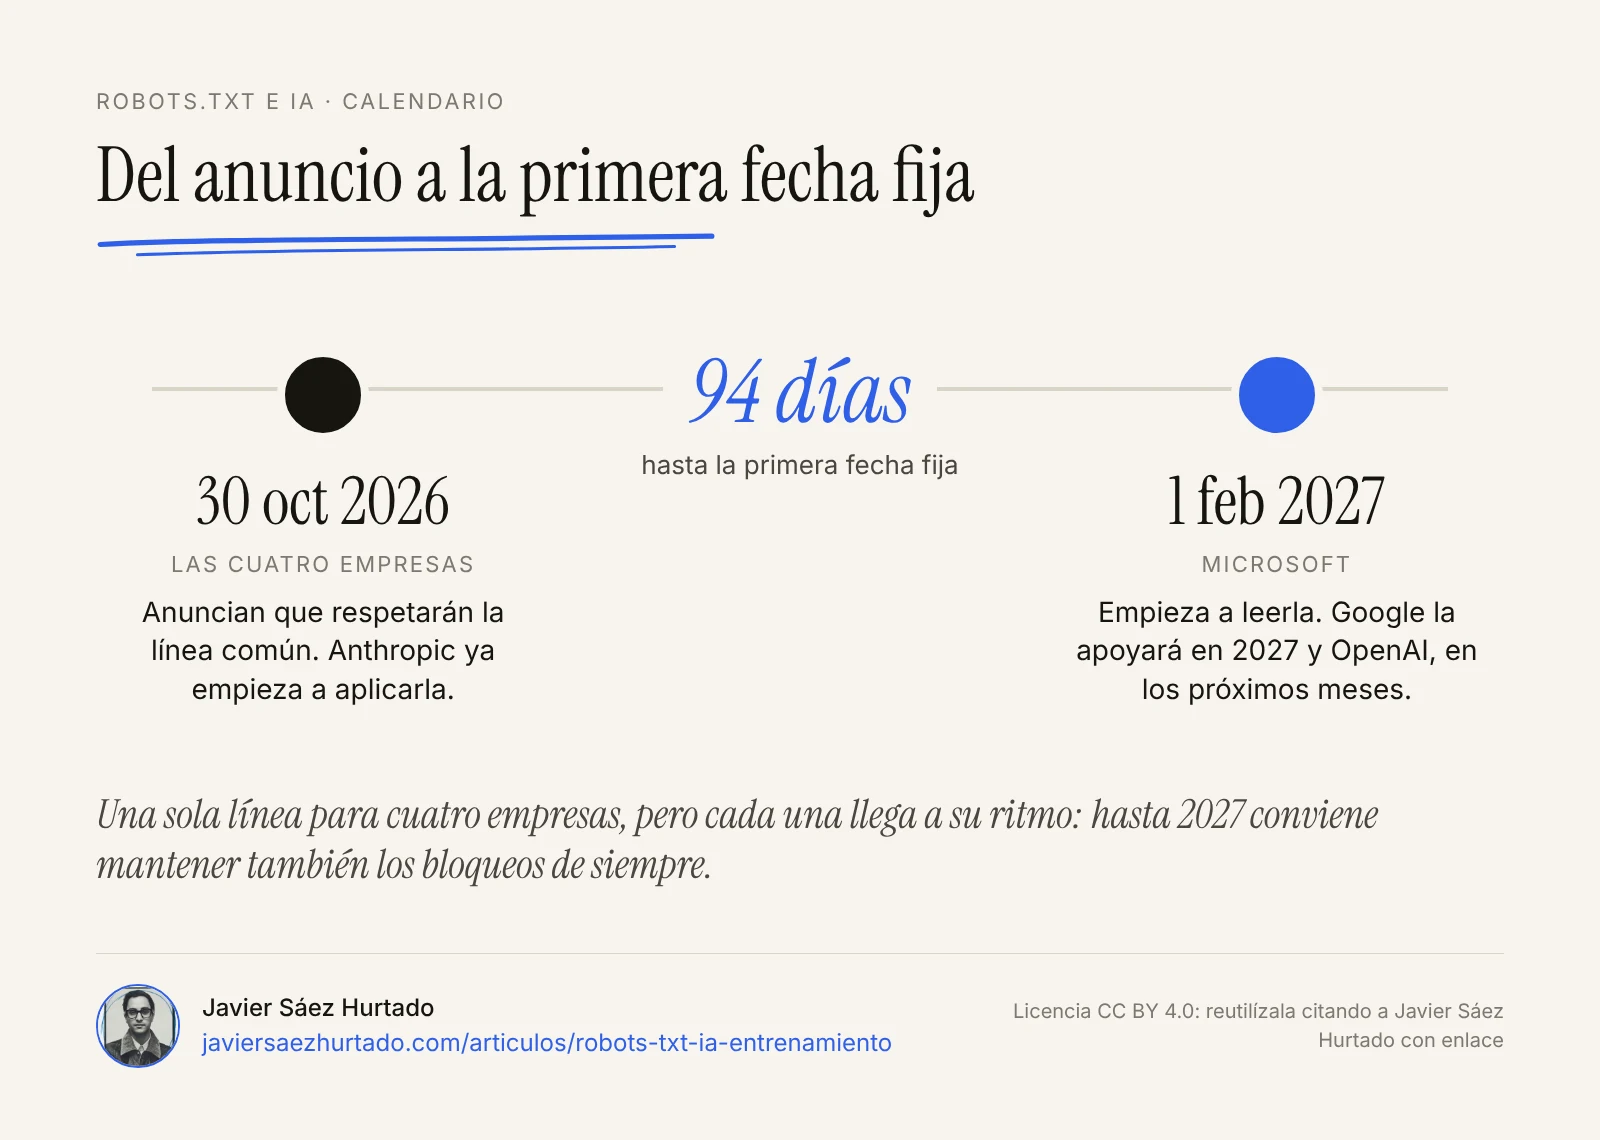
El caso de Google tiene un matiz: si tu robots.txt bloquea el entrenamiento con la línea común y no dice nada de Google-Extended, Google lo interpretará como si hubieras bloqueado Google-Extended. Si escribes una regla expresa para Google-Extended, manda esa. Así puedes, por ejemplo, decir que no a todos y que sí a Google, o al revés.
Microsoft es la que más cambia. Desde el 1 de febrero de 2027 leerá la línea común y separa dos preferencias: entrenamiento y grounding, que es usar tu página como fuente en una respuesta de IA. El grounding solo se fija página a página, no en robots.txt. Y después del 1 de marzo de 2027 deja de leer NoArchive y NoCache como señales de entrenamiento o de grounding. Para las webs que usen esas etiquetas el 15 de diciembre de 2026, habrá una preferencia temporal en Bing Webmaster Tools.
¿Bloquear el entrenamiento te saca de Google, ChatGPT o Gemini?
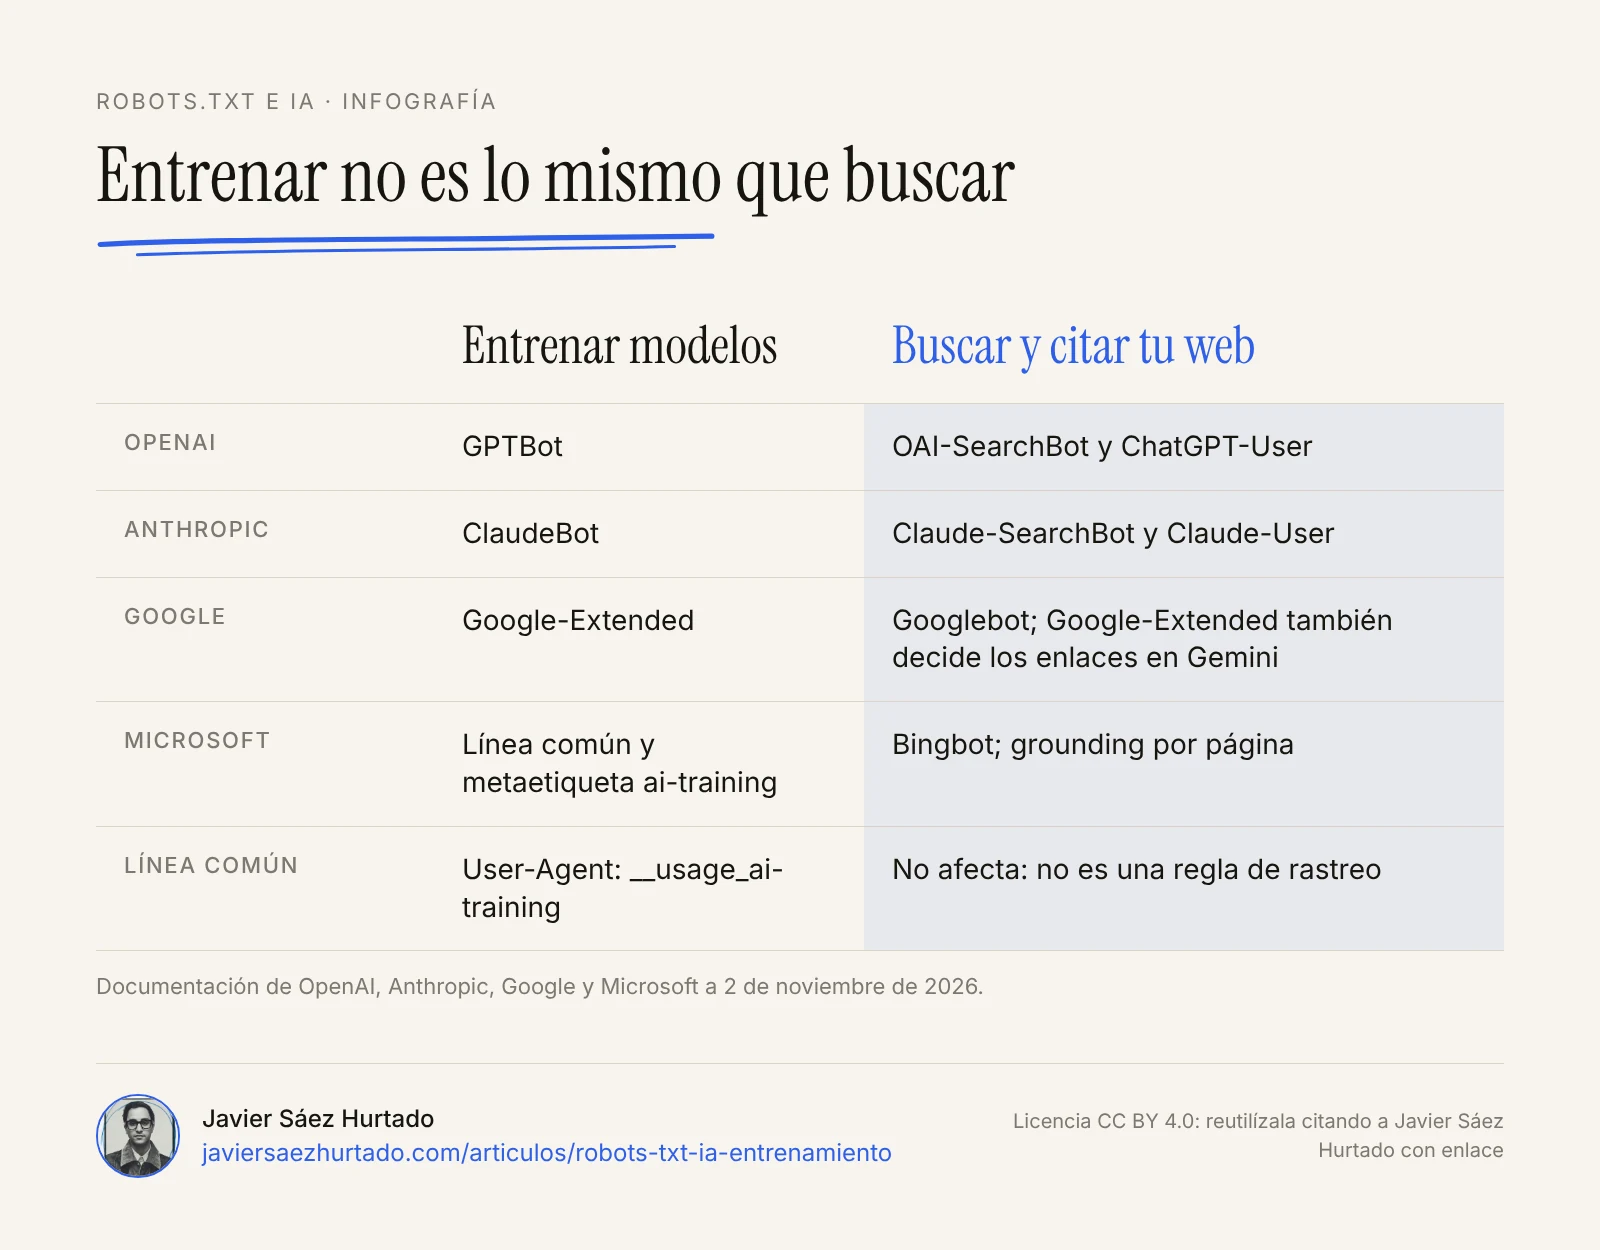
No, si lo haces bien. La línea común solo habla del entrenamiento. Las cuatro empresas separan, cada una a su manera, el rastreo para entrenar del rastreo para buscar o para responder a una persona:
- OpenAI. GPTBot es el de entrenamiento; OAI-SearchBot, el de búsqueda en ChatGPT; ChatGPT-User entra cuando una persona le pide algo y el asistente navega por ella. Su documentación dice que cada ajuste es independiente de los demás.
- Anthropic. ClaudeBot es el de entrenamiento; Claude-SearchBot, el de búsqueda, y Claude-User, el que visita una página a petición de alguien.
- Google. Google-Extended no afecta a la búsqueda de Google, pero sí decide si tu web puede salir con enlace en las respuestas de las apps de Gemini. Google lo dice en su anuncio: las webs que permiten Google-Extended pueden aparecer y recibir clics en esas respuestas. Si te importa salir en Gemini, esta es la regla que hay que pensar dos veces.
- Microsoft. El entrenamiento y el grounding van por separado, como explicaba arriba, y ninguno de los dos cambia el rastreo de Bingbot.
El riesgo real está en el error de escritura. Un Disallow: / debajo de User-Agent: *, en lugar de debajo del token, le dice a todos los buscadores que no entren en tu web. Es un cambio de una línea con efectos que tardan semanas en deshacerse.
¿Qué cambia para empresas en España y Europa?
En la Unión Europea, la línea nueva llega a un terreno que ya tenía reglas. La directiva de derechos de autor de 2019 permite la minería de textos y datos, que incluye recoger contenido para entrenar modelos, salvo que el titular se haya reservado ese uso «de manera adecuada», por ejemplo con medios de lectura mecánica si el contenido está publicado en internet (artículo 4, apartado 3). En España, esa excepción está en el artículo 67 de la Ley de Propiedad Intelectual, en la versión del Real Decreto-ley 24/2021.
El AI Act añade la otra mitad. Desde el 2 de agosto de 2025, quien ofrece en la UE un modelo de IA de uso general debe tener una política para cumplir el derecho de autor europeo y, en particular, para detectar y respetar esas reservas (artículo 53). El código de buenas prácticas que publicó la Comisión en julio de 2025 concreta que los rastreadores deben leer y seguir robots.txt según el RFC 9309.
Lo que no tenía esa regla era un formato común. Cada empresa interpretaba robots.txt con sus propios nombres de rastreador, y una web que quería reservarse el entrenamiento no sabía si lo había hecho bien para todas. La línea común resuelve una parte del problema, con dos límites:
- Es un borrador individual. La IETF advierte que no tiene su respaldo ni rango formal. Puede cambiar, y el vocabulario del que sale (draft-ietf-aipref-vocab) todavía no refleja consenso del grupo de trabajo.
- No es retroactiva. Cuentan las preferencias del robots.txt vigente cuando se descargó el contenido. Lo que ya está en un modelo no sale de él.
Para una empresa española, la consecuencia práctica es sencilla: si quieres reservarte el entrenamiento, ahora tienes una forma más clara de dejarlo por escrito, que además encaja con lo que el derecho europeo pide a los proveedores. Si lo que quieres es que la IA te conozca y te cite, no tienes que hacer nada; pero conviene que sea una decisión, no una casualidad.
¿Qué revisaría hoy en mi web?
Antes de tocar nada, haría estas comprobaciones, en este orden:
- Qué tienes ahora. Abre tuweb.com/robots.txt y mira qué rastreadores bloqueas. Muchas webs bloquean GPTBot desde 2023 sin recordarlo, o tienen reglas de un plugin que nadie revisa.
- Qué quieres en cada sección. No es lo mismo el blog público que el área de clientes, las fichas de producto o los informes de pago. La línea admite rutas: puedes decir que no al entrenamiento en una carpeta y que sí en otra.
- Si quieres salir en respuestas de IA. Bloquear el entrenamiento no te quita de la búsqueda, pero en Gemini Google-Extended mezcla las dos cosas. Decide qué pesa más para ti.
- Quién más toca el archivo. El CMS, el CDN o un plugin de SEO pueden reescribir robots.txt. Comprueba el archivo publicado, no el que crees que hay.
- Que la decisión quede escrita. Una nota interna con qué se decidió, quién y cuándo. Si mañana una empresa de IA pregunta, o firma una licencia contigo, sabrás desde cuándo estaba la reserva.
Mi criterio: una preferencia, no un candado
Me parece una buena noticia, sobre todo por lo que tiene de orden. Que cuatro empresas que compiten en todo lean la misma línea simplifica la vida a cualquiera que tenga una web, y es una forma razonable de dar efecto práctico a una regla europea que ya existía. Que el autor sea de Anthropic, la empresa que acaba de presentar su solicitud para salir a bolsa, y que el texto esté en la IETF, a la vista de todos, también ayuda.
Pero conviene no confundir una preferencia con un candado. robots.txt funciona porque las empresas serias deciden respetarlo; un rastreador que no quiera, no lo hará. Si un contenido no puede acabar en manos de terceros bajo ningún concepto, la protección está en no publicarlo en abierto, no en una línea de texto.
En mi propia web he decidido lo contrario de bloquear: su robots.txt permite de forma expresa a los rastreadores de búsqueda y también a los de entrenamiento. Escribo para que esta información llegue lejos y quiero que los asistentes la conozcan y la citen. Es una decisión que tiene sentido para una web personal de divulgación y que no copiaría tal cual en una empresa con contenido de pago o con datos de clientes.
Y un último consejo, el mismo que doy con los agentes en qué le dejarías hacer a un agente sin mirar: este cambio lo haría una persona, a mano, y lo revisaría otra. Es un archivo de pocas líneas que decide si tu web aparece en los buscadores. No es algo que dejaría en manos de un plugin automático ni de un agente de IA sin mirar el resultado.
Transparencia: Convexify, la firma que fundé, forma parte del programa OpenAI Select Partner. Este artículo se basa en la documentación pública de OpenAI, Google, Microsoft y Anthropic, en los borradores de la IETF y en las fuentes enlazadas.
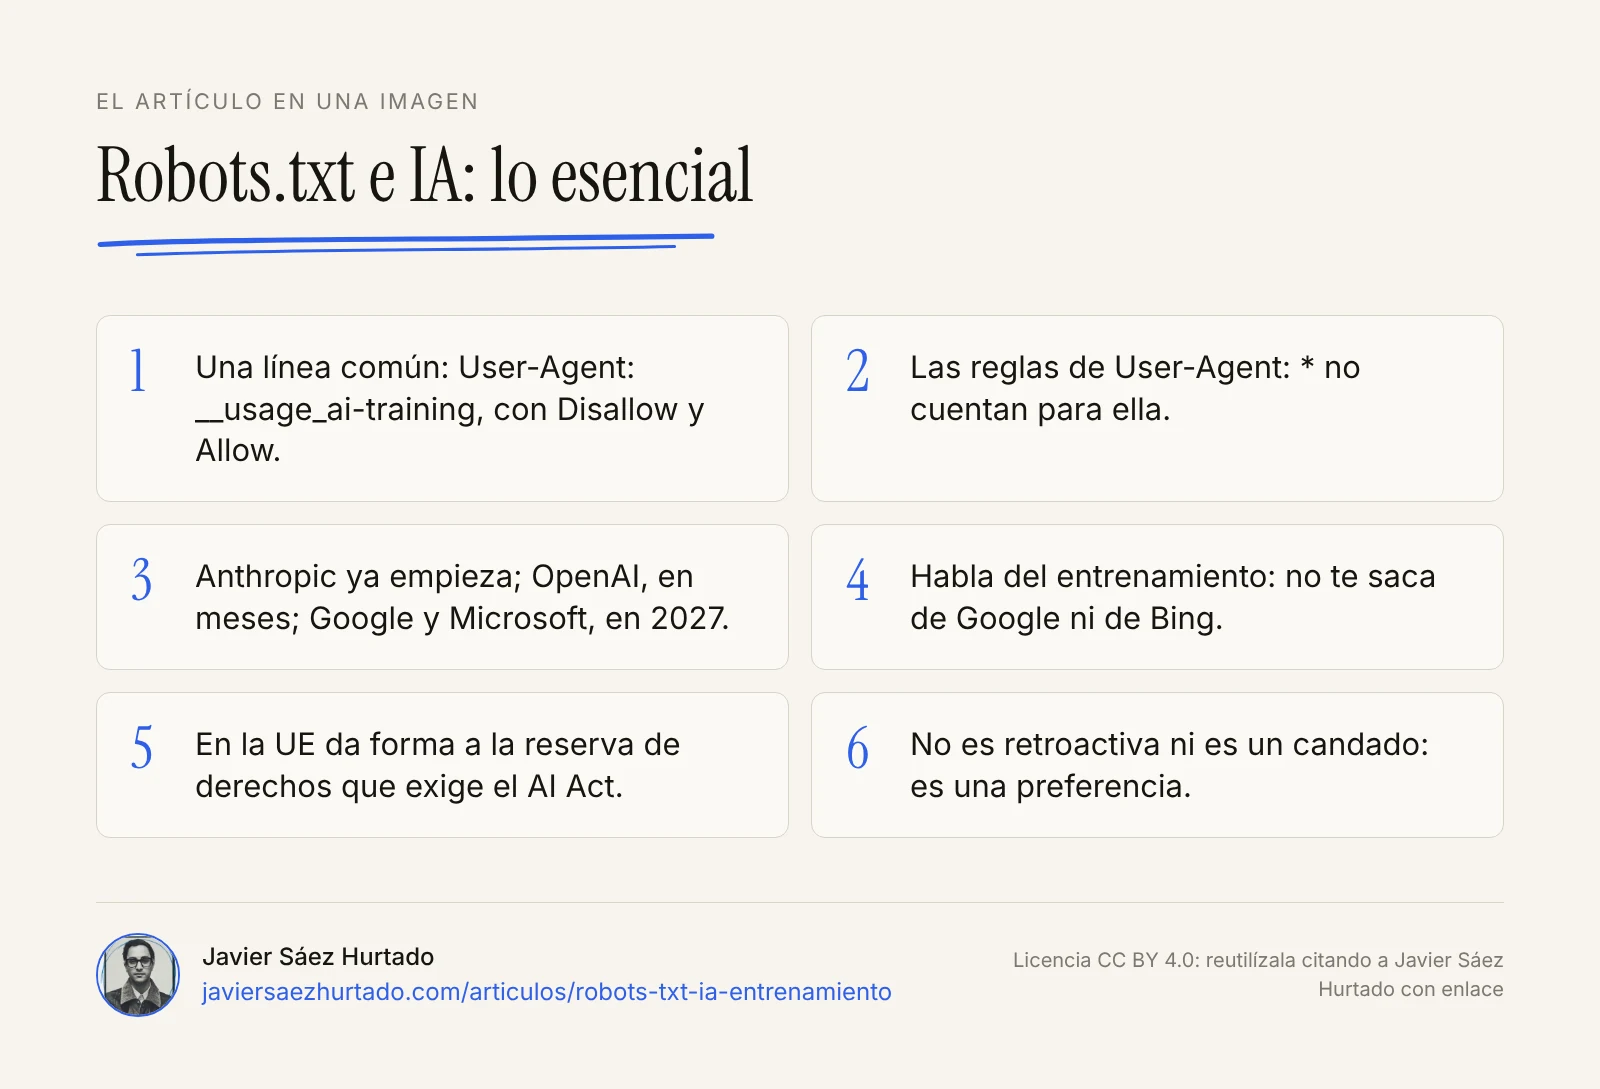
Lo que conviene recordar
- La línea común es
User-Agent: __usage_ai-training, con Disallow y Allow como siempre. Las reglas deUser-Agent: *no cuentan para ella. - Anthropic ya ha empezado; OpenAI, en los próximos meses; Google, en 2027; Microsoft, desde el 1 de febrero de 2027.
- Habla del entrenamiento, no del rastreo: no te saca de Google ni de Bing. Google-Extended sí afecta a las respuestas con enlace de Gemini.
- En la UE da forma a la reserva de derechos por medios de lectura mecánica que el AI Act obliga a respetar desde el 2 de agosto de 2025.
- No es retroactiva ni es un candado: lo que ya se usó no se borra y un rastreador que no quiera respetarla no lo hará.
El artículo en una imagen
Preguntas frecuentes
¿Qué es __usage_ai-training?
Es un «token de política» que se escribe en robots.txt como si fuera el nombre de un rastreador (User-Agent: __usage_ai-training). Con las reglas Disallow y Allow de siempre, la web dice qué partes no quiere que se usen para entrenar modelos de IA y cuáles sí. Lo define un borrador de la IETF del 30 de octubre de 2026.
¿Cómo impido que la IA entrene con mi web?
Hoy hay que combinar dos cosas: bloquear en robots.txt los rastreadores de entrenamiento de cada empresa (GPTBot, ClaudeBot, Google-Extended) y añadir el grupo común User-Agent: __usage_ai-training con Disallow: /, que las cuatro grandes irán respetando entre ahora y 2027. Ninguna de las dos cosas borra lo que ya se usó para entrenar.
¿Bloquear el entrenamiento me saca de Google o de ChatGPT?
No. La línea común solo expresa una preferencia sobre el entrenamiento, y Google y Microsoft separan el entrenamiento de la búsqueda. En OpenAI, GPTBot (entrenamiento) y OAI-SearchBot (búsqueda) se controlan por separado. Ojo con Google-Extended: también decide si tu web aparece con enlace en las respuestas de Gemini.
¿Cuándo empezarán a respetarlo OpenAI, Google y Microsoft?
Anthropic dice que ya ha empezado a implantarlo. OpenAI habla de los próximos meses, Google de 2027 y Microsoft lo leerá desde el 1 de febrero de 2027. Microsoft da hasta el 1 de marzo de 2027 para pasar de NoArchive y NoCache a las nuevas preferencias.
¿Están obligadas las empresas de IA a respetar robots.txt en Europa?
Quien entrena modelos de IA de uso general para el mercado de la UE debe tener, desde el 2 de agosto de 2025, una política para respetar las reservas de derechos hechas por medios de lectura mecánica (artículo 53 del AI Act y artículo 4 de la directiva de derechos de autor). El código de buenas prácticas de la Comisión cita robots.txt. La línea nueva no es ley: es una forma común de expresar esa reserva.
¿Sirve para quitar mi contenido de modelos ya entrenados?
No. El borrador dice que cuentan las preferencias del robots.txt vigente cuando se descargó el contenido. Lo que ya se recogió antes no se borra de los modelos por añadir la línea ahora.
Fuentes
- IETF, Machine-Readable Training Preference Signal, draft-kelley-aipref-training-preference-signal-00 (30 oct 2026)
- Kevin Kelley (Anthropic), mensaje a la lista ai-control de la IETF (30 oct 2026)
- Google Search Central, Supporting a shared AI training control for websites (30 oct 2026)
- Microsoft Bing, Your content, your choice: clearer preferences for training and grounding (30 oct 2026)
- OpenAI, Making it easier for websites to express AI training preferences (30 oct 2026)
- OpenAI, rastreadores y agentes de usuario de OpenAI (consultado el 2 nov 2026)
- Anthropic, rastreo de la web y cómo impedirlo (consultado el 2 nov 2026)
- IETF, A Vocabulary For Expressing AI Usage Preferences, draft-ietf-aipref-vocab-08 (14 sep 2026)
- RFC 9309, Robots Exclusion Protocol
- Google Search Central, introducción a robots.txt
- Directiva (UE) 2019/790 sobre los derechos de autor en el mercado único digital (artículo 4)
- Reglamento (UE) 2024/1689 de inteligencia artificial (artículo 53)
- Freshfields, The final General-Purpose AI Code of Practice: a short guide (jul 2025)
- Cuatrecasas, transposición de la Directiva 2019/790 en España
- Search Engine Journal, Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out (1 nov 2026)
- PPC Land, Google, Microsoft, OpenAI and Anthropic back one AI training opt-out (31 oct 2026)