Guía de estudio de IA · Módulo 1. Fundamentos
Redes neuronales: qué son y cómo funcionan, explicado sin fórmulas
Una red neuronal es un modelo de machine learning formado por capas de unidades muy simples que se pasan números entre sí; aprende ajustando la importancia de cada conexión hasta que sus respuestas se parecen a las correctas. Es la pieza de la que están hechos los modelos actuales de lenguaje, imagen y voz.
¿Qué es una red neuronal?
Una red neuronal es un modelo de machine learning formado por muchas unidades simples, organizadas en capas, que se pasan números unas a otras. Cada conexión tiene un peso que indica cuánto importa, y la red aprende ajustando esos pesos a partir de ejemplos.
Si vienes de la lección de machine learning, una red neuronal es un tipo concreto de modelo: el que más se usa hoy. Su ventaja, como explica Google en su curso de machine learning, es que descubre sola qué combinaciones de datos le sirven para equivocarse menos, sin que nadie tenga que diseñarlas a mano.
¿Se parece de verdad a un cerebro?
Se parece poco. Las redes neuronales se inspiraron en las neuronas biológicas, pero una neurona artificial es una operación matemática muy sencilla, no una copia de una neurona real.
El curso CS231n de Stanford lo describe como un modelo de neurona muy tosco. En el cerebro hay muchos tipos de neuronas, cada sinapsis es un sistema complejo y no un simple número, y el momento exacto en que se dispara una señal también cuenta. Y el sistema nervioso humano tiene unos 86.000 millones de neuronas. La palabra «neuronal» es una metáfora útil, no una descripción.
¿Cuáles son las partes de una red neuronal?
Una red neuronal tiene una capa de entrada que recibe los datos, una o varias capas ocultas que los transforman y una capa de salida que da la respuesta. Entre capa y capa, cada conexión tiene un peso.
Piensa en una decisión cotidiana: ¿te llevas el paraguas? Miras varios datos (si el cielo está gris, qué dice la app del tiempo, si vas a ir andando) y no todos pesan igual. Sumas mentalmente, y si el resultado pasa de cierto listón, coges el paraguas. Una neurona artificial hace exactamente eso, pero con números.
- Entradas
- Los datos que recibe la red: los píxeles de una foto, las palabras de una frase o las columnas de una tabla.
- Pesos
- Un número por cada conexión que dice cuánto importa ese dato. Son los parámetros que se ajustan al entrenar. Junto a ellos hay un ajuste extra, el sesgo, que mueve el listón de decisión.
- Capas
- Grupos de neuronas que trabajan a la vez. Cada capa recibe lo que calculó la anterior y se lo pasa, transformado, a la siguiente.
- Activación
- La regla que decide qué deja pasar cada neurona. Una de las más usadas, ReLU, es muy simple: si el resultado es negativo, devuelve cero; si no, lo deja pasar tal cual.
- Salida
- La respuesta final: una categoría («gato»), un número (un precio) o la siguiente palabra de un texto.
La activación parece un detalle, pero es lo que hace útil a la red. Sin ella, encadenar capas no sirve de nada: como explica Google, operaciones lineales sobre operaciones lineales siguen siendo lineales. Con ella, cada capa puede aprender algo un poco más complejo que la anterior.
Las capas funcionan como una cadena de personas mirando una foto. Según IBM, en las redes de imágenes las primeras capas detectan colores y bordes, las siguientes formas y las últimas el objeto.
Así viaja una señal por una red neuronal
Animación: una red decide si en una foto hay un gato o un perro (cifras de ejemplo)
¿Cómo aprende una red neuronal?
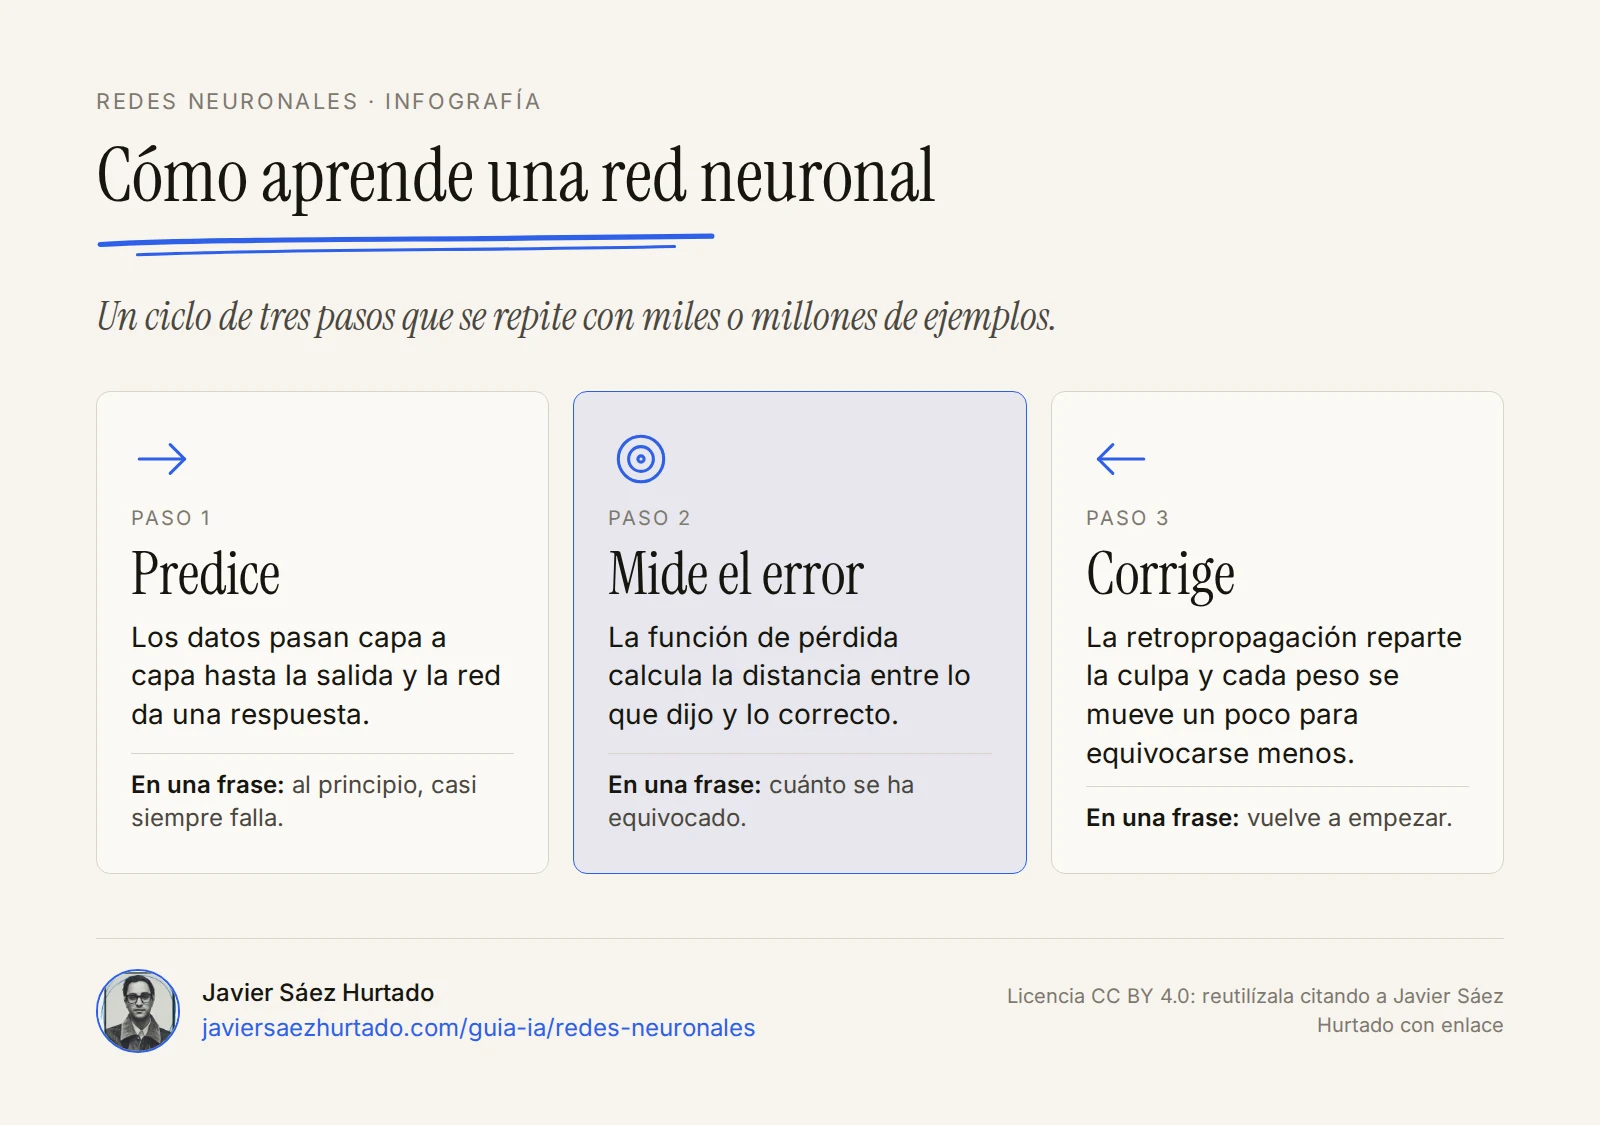
Una red neuronal aprende por ensayo y error: da una respuesta, la compara con la correcta y corrige un poco sus pesos. Lo repite con miles o millones de ejemplos.
El ciclo tiene cuatro pasos, que IBM describe en su guía:
- Pasada hacia delante. La red recibe un ejemplo y produce una respuesta. Al principio, con pesos al azar, casi siempre falla.
- Medir el error. Una fórmula, llamada función de pérdida, mide la distancia entre lo que ha dicho y lo que debía decir.
- Retropropagación. El error se recorre hacia atrás, de la salida a la entrada, para calcular cuánto ha contribuido cada peso. Es un reparto de culpas: qué conexiones empujaron hacia la respuesta equivocada y cuánto.
- Descenso del gradiente. Cada peso se mueve un poco en la dirección que reduce el error.
La imagen clásica para el último paso es bajar una montaña con niebla. No ves el valle, pero notas hacia dónde baja el suelo bajo tus pies y das un paso en esa dirección. El tamaño de ese paso se llama tasa de aprendizaje: si es demasiado grande, te pasas de largo; si es demasiado pequeño, no llegas nunca.
Google la define como el algoritmo de entrenamiento más habitual en redes neuronales. Las bibliotecas de programación la hacen solas: nadie calcula esto a mano.
¿Qué significa «deep» en deep learning?
Deep learning (aprendizaje profundo) significa usar redes neuronales con muchas capas. «Profundo» se refiere al número de capas, no a que la red entienda nada en profundidad.
IBM habla de deep learning a partir de unas cuatro capas, y añade que las arquitecturas modernas suelen ser mucho más profundas. Más capas permiten aprender patrones más complejos, pero exigen más datos y más cálculo. El deep learning tendrá su propia lección más adelante.
¿Qué tipos de redes neuronales existen?
Hay muchos, pero cuatro familias explican casi todo lo que verás. Se diferencian en cómo se conectan las neuronas y, por tanto, en qué datos manejan mejor.
Los cuatro tipos de red neuronal más habituales
Qué hace cada uno y dónde te lo encuentras
| Totalmente conectada | Convolucional (CNN) | Recurrente (RNN) | Transformer | |
|---|---|---|---|---|
| Idea clave | Cada neurona se conecta con todas las de la capa siguiente. | Filtros que recorren la imagen buscando bordes, formas y objetos. | Recuerda lo que ha visto antes en una secuencia. | Mira todo el texto a la vez y decide a qué partes prestar atención. |
| Mejor con | Datos en tabla. | Imágenes y vídeo. | Secuencias: voz, series temporales. | Lenguaje, y cada vez más imagen y audio. |
| Ejemplo | Estimar un precio a partir de varias características. | Etiquetado de fotos, detección de carril. | Reconocimiento de voz, sensores. | Los modelos de lenguaje como ChatGPT, Claude o Gemini (ver qué es un LLM). |
A las redes recurrentes les cuesta conectar información muy separada en un texto largo. IBM señala que su uso ha bajado en favor de los transformers, que relacionan mejor la información lejana y se entrenan en paralelo.
¿De dónde salen las redes neuronales?
La idea tiene más de 80 años, pero solo funciona a gran escala desde hace poco más de una década. Estos son los hitos principales:
- 1943. Warren McCulloch y Walter Pitts proponen el primer modelo matemático de una neurona.
- 1958. Frank Rosenblatt publica el perceptrón en Psychological Review. Ese julio, la Marina de Estados Unidos presentó la máquina: tras 50 intentos aprendió a distinguir tarjetas marcadas a la izquierda de tarjetas marcadas a la derecha.
- 1969. Marvin Minsky y Seymour Papert publican Perceptrons, una crítica que enfrió la investigación durante años.
- 1986. David Rumelhart, Geoffrey Hinton y Ronald Williams describen la retropropagación en Nature. Su gran aportación: las capas ocultas aprenden por sí solas a representar rasgos útiles del problema.
- 2012. AlexNet, de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton, gana el concurso ImageNet de clasificación de imágenes con un 15,3 % de error, frente al 26,2 % del mejor equipo rival. Tenía 60 millones de parámetros y se entrenó con tarjetas gráficas.
- 2017. Un equipo de investigadores, casi todos de Google, presenta el transformer en el artículo Attention Is All You Need.
- 2024. John Hopfield y Geoffrey Hinton reciben el Nobel de Física por descubrimientos e invenciones fundamentales que hacen posible el machine learning con redes neuronales artificiales.
El salto de 2012 es la clave. Las ideas ya existían; lo que cambió fue que había muchos más datos y tarjetas gráficas capaces de hacer millones de cálculos en paralelo.
¿Dónde usas redes neuronales sin saberlo?
Usas redes neuronales cada vez que tu móvil entiende lo que le dictas, una app traduce un texto o un asistente de IA te responde.
IBM cita, entre otros, el etiquetado de fotos en redes sociales, la búsqueda por imagen en tiendas online, el análisis de imágenes médicas y la detección de carril en coches. Y los chatbots: los modelos que hay detrás son redes enormes de tipo transformer.
Ejemplo práctico: ¿cómo ver aprender a una red neuronal?
Puedes entrenar una red neuronal en tu navegador, sin instalar nada ni programar, con Neural Network Playground, una herramienta gratuita y de código abierto de TensorFlow que el curso de Google usa en sus ejercicios.
- Abre playground.tensorflow.org.
- Elige el conjunto de datos con forma de espiral y deja las propiedades de entrada como vienen. El reto es separar los puntos naranjas de los azules.
- Pulsa el botón de reproducir y mira la pérdida (Training loss y Test loss). Si baja, la red está aprendiendo. El color del fondo es lo que la red predice en cada zona.
- Fíjate en las líneas entre neuronas: son los pesos. Su grosor indica su tamaño y el color, si suman o restan.
- Reinicia y quita todas las capas ocultas con el botón de menos. Vuelve a entrenar: verás que la red no consigue separar la espiral.
- Añade capas y neuronas, prueba la activación ReLU y cambia la tasa de aprendizaje. Luego elige la activación Linear: aunque pongas muchas capas, la red vuelve a fallar.
En estos pocos pasos habrás visto casi toda esta lección: pesos, capas, activación, tasa de aprendizaje y pérdida. Si prefieres verlo explicado, la serie de vídeos de 3Blue1Brown sobre redes neuronales es un buen complemento.
¿Qué límites tienen las redes neuronales?
Las redes neuronales tienen tres límites que conviene conocer: necesitan muchos datos, consumen mucha energía y es difícil explicar por qué dan cada respuesta.
- Hambre de datos. IBM recuerda que las redes grandes necesitan enormes cantidades de ejemplos, y que reunirlos y etiquetarlos puede ser carísimo. Con pocos datos tienden a memorizar en lugar de aprender la regla (sobreajuste).
- Energía y cálculo. Entrenarlas y usarlas exige mucho cálculo. La Agencia Internacional de la Energía estima que los centros de datos consumieron unos 415 TWh en 2024, cerca del 1,5 % de la electricidad mundial, y prevé que se duplique hasta unos 945 TWh en 2030. Casi la mitad de ese aumento vendría de los servidores especializados, impulsados sobre todo por la IA.
- Caja negra. Una red puede acertar sin que nadie sepa explicar por qué. Según IBM, más allá de la explicación matemática, a menudo no hay forma intuitiva de saber qué representa cada parámetro.
Hay un cuarto límite que se deduce de todo lo anterior: una red aprende patrones de sus datos, no comprende el mundo. Si los datos tienen sesgos o huecos, la red los hereda.
Lo que yo tendría en cuenta
No hace falta saber programar una red neuronal para usar bien la IA, pero sí entender que debajo hay estadística, no comprensión. Eso explica lo mucho que acierta y lo seguro que suena cuando se equivoca.
Por eso, cuando una decisión importa de verdad (algo que se publica en mi nombre, algo que no se puede deshacer, algo que toca a otras personas), no me basta con que el modelo acierte casi siempre. Quiero una persona que revise antes de que tenga efecto. Y la confianza en un sistema la doy a medida que lo pruebo con trabajo real, no por lo bien que funciona en una demostración.
Lo que conviene recordar
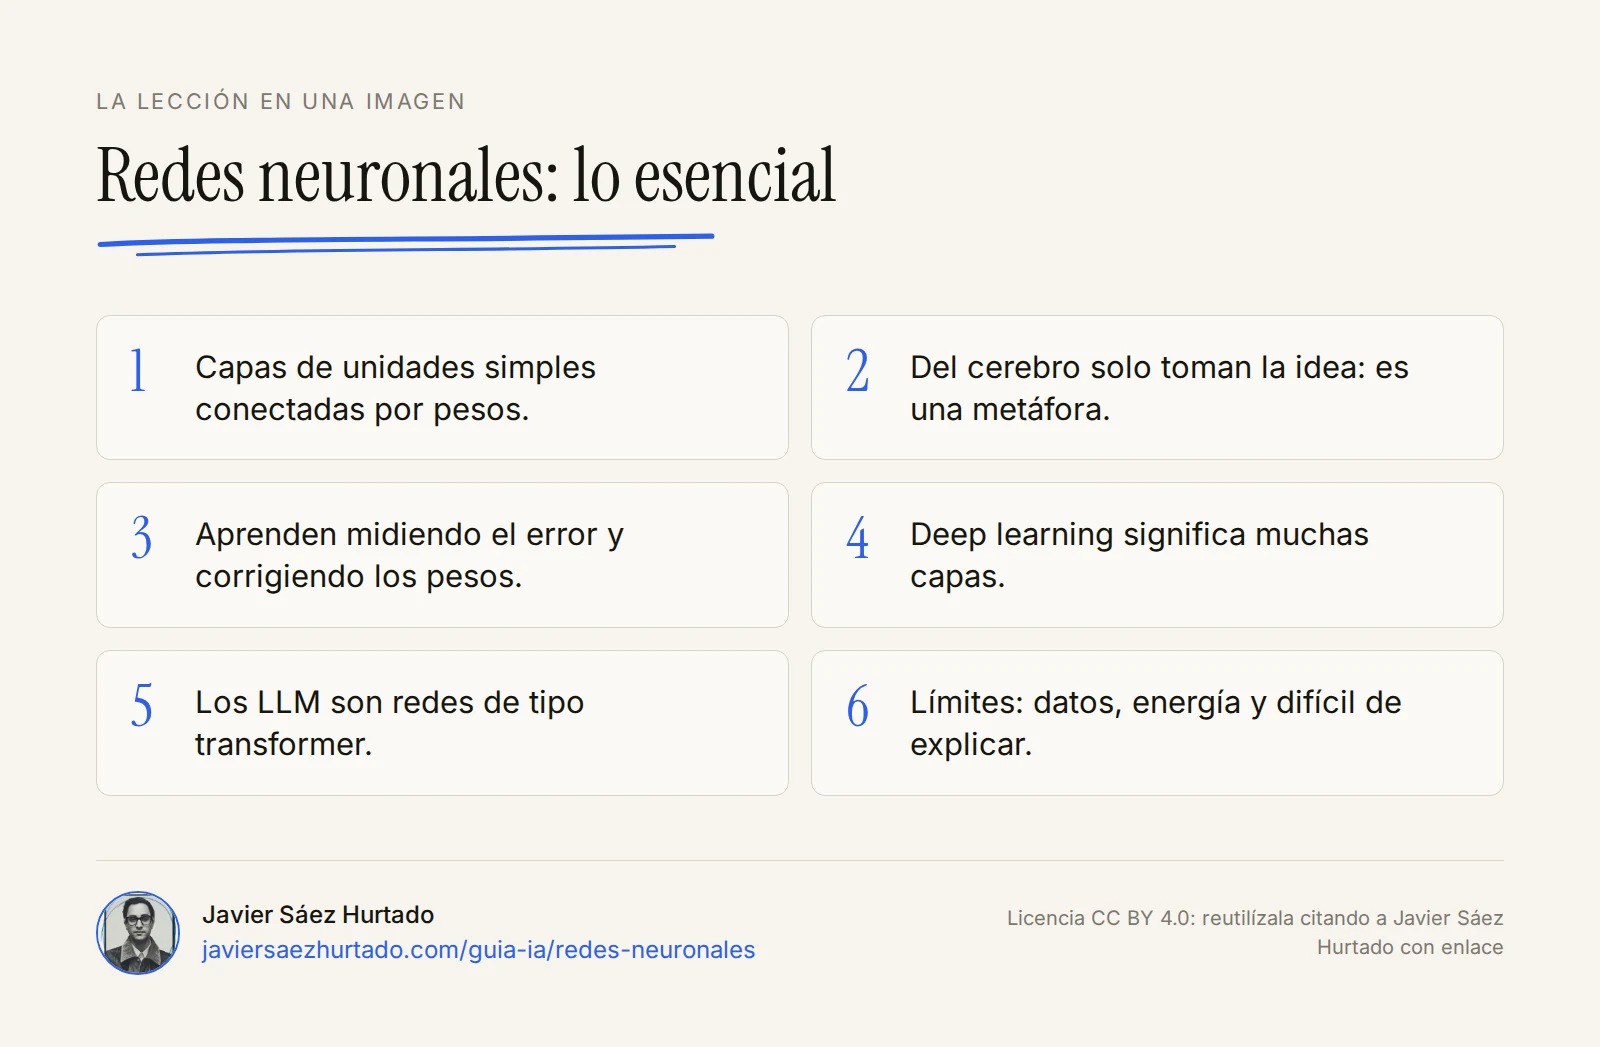
- Una red neuronal es un modelo hecho de capas de unidades simples; cada conexión tiene un peso que se ajusta al entrenar.
- La comparación con el cerebro es una metáfora: una neurona artificial es mucho más simple que una real.
- Aprende midiendo su error, repartiendo la culpa hacia atrás (retropropagación) y corrigiendo los pesos poco a poco (descenso del gradiente).
- Deep learning significa redes con muchas capas, y los modelos de lenguaje actuales son redes de tipo transformer.
- Necesitan muchos datos y mucha energía, y es difícil explicar sus respuestas: para lo importante, revisión humana.
La lección en una imagen
Preguntas frecuentes
¿Qué es una red neuronal en palabras sencillas?
Es un programa formado por muchas unidades simples organizadas en capas que se pasan números entre sí. Cada conexión tiene un peso que indica cuánto importa, y la red aprende ajustando esos pesos a partir de ejemplos hasta acertar cada vez más.
¿Las redes neuronales funcionan como el cerebro humano?
No. Se inspiraron en las neuronas biológicas, pero una neurona artificial es una operación matemática muy simplificada. Las neuronas reales, sus conexiones y la forma en que aprenden son mucho más complejas, así que la comparación es una metáfora útil, no una descripción.
¿Qué diferencia hay entre machine learning, redes neuronales y deep learning?
El machine learning es la forma de construir IA que aprende de ejemplos. Las redes neuronales son un tipo de modelo de machine learning. El deep learning es el uso de redes neuronales con muchas capas, que es lo que hay detrás de casi toda la IA actual.
¿Qué es la retropropagación?
Es el método más habitual para entrenar redes neuronales. Después de cada error, recorre la red desde la salida hacia la entrada y calcula cuánto ha contribuido cada peso a ese error, para saber cuál corregir y en qué dirección.
¿ChatGPT es una red neuronal?
Sí. Los modelos que hay detrás de ChatGPT, Claude o Gemini son redes neuronales muy grandes de tipo transformer, una arquitectura presentada en 2017. OpenAI describe GPT-4, por ejemplo, como un modelo basado en transformer entrenado para predecir la siguiente pieza de texto.
¿Para qué se usan las redes neuronales en el día a día?
Están detrás del reconocimiento de voz, la traducción automática, la búsqueda por imagen, el etiquetado de fotos, los asistentes de lenguaje y algunas ayudas a la conducción, como la detección de carril. La mayoría de las veces las usas sin darte cuenta.
Fuentes
- Google, Machine Learning Crash Course: Neural networks
- Google, Machine Learning Crash Course: Activation functions
- Google, Machine Learning Crash Course: Training using backpropagation
- IBM, What is a neural network?
- IBM, What is deep learning?
- IBM, What are convolutional neural networks?
- IBM, What is a recurrent neural network?
- Stanford CS231n, Neural Networks Part 1: Setting up the Architecture
- Rosenblatt, The perceptron: a probabilistic model for information storage and organization in the brain (Psychological Review, 1958)
- Cornell Chronicle, Professor’s perceptron paved the way for AI, 60 years too soon (2019)
- Rumelhart, Hinton y Williams, Learning representations by back-propagating errors (Nature, 9 oct 1986)
- Krizhevsky, Sutskever y Hinton, ImageNet Classification with Deep Convolutional Neural Networks (NIPS 2012)
- ImageNet, resultados de ILSVRC 2012
- Vaswani et al., Attention Is All You Need (arXiv, 12 jun 2017)
- OpenAI, GPT-4 Technical Report (2023)
- Premio Nobel de Física 2024, nota de prensa
- IEA, Energy and AI: Energy demand from AI (2025)
- TensorFlow, Neural Network Playground
- 3Blue1Brown, But what is a neural network? (vídeo de apoyo)