Guía de estudio de IA · Módulo 1. Fundamentos
Machine learning: qué es, cómo aprende una máquina y para qué sirve
El machine learning, o aprendizaje automático, es una forma de construir inteligencia artificial en la que el sistema aprende patrones a partir de ejemplos en lugar de seguir reglas escritas a mano. Esta lección explica cómo aprende, qué tipos hay, dónde lo usas cada día y dónde falla.
¿Qué es el machine learning?
El machine learning, o aprendizaje automático, es la parte de la inteligencia artificial en la que un sistema aprende patrones a partir de ejemplos, en lugar de seguir reglas que alguien ha escrito a mano. Con esos patrones puede hacer predicciones sobre datos que no ha visto nunca.
Google lo define como una forma de entrenar un programa, llamado modelo, para que haga predicciones útiles o genere contenido a partir de datos. Nadie le explica al modelo cómo se reconoce un correo basura: se le enseñan miles de correos y él encuentra qué tienen en común.
- Modelo
- El programa que resulta del entrenamiento. Recibe una entrada (un correo, una foto, una frase) y devuelve una salida (spam o no, gato o perro, la siguiente palabra).
- Entrenamiento
- La fase en la que el modelo ajusta sus valores internos a partir de datos hasta que sus respuestas se parecen a las correctas.
- Inferencia
- El uso del modelo ya entrenado con casos nuevos. Es lo que ocurre cada vez que escribes a un chatbot.
¿En qué se diferencia de la inteligencia artificial y del deep learning?
La inteligencia artificial es el campo general y el machine learning es una parte de él: todo el machine learning es IA, pero no toda la IA es machine learning. IBM pone como ejemplo los termostatos basados en reglas: uno que enciende la calefacción cuando la casa baja de 20 grados decide solo, pero sigue una regla fija y no aprende nada.
El deep learning, o aprendizaje profundo, es a su vez un tipo de machine learning. Usa redes neuronales con muchas capas y es el enfoque que domina hoy en texto, imagen y voz. Lo verás en la lección sobre redes neuronales. Por ahora, imagina tres cajas, una dentro de otra: IA, machine learning y deep learning.
¿De dónde viene la idea de aprender con ejemplos?
La idea tiene más de setenta años. En los años cincuenta, Arthur Samuel, investigador de IBM, programó un ordenador IBM 701 para jugar a las damas y le añadió mecanismos para aprender de las partidas que ya había jugado. IBM le atribuye la invención del término «machine learning».
En 1959 publicó sus resultados en el IBM Journal of Research and Development, en el artículo «Some Studies in Machine Learning Using the Game of Checkers». Su conclusión era llamativa para la época: se podía programar un ordenador para que aprendiera a jugar a las damas mejor que la persona que lo había programado, y lograrlo en unas 8 o 10 horas de juego de la máquina. En la introducción ya apuntaba la idea central: enseñar a los ordenadores a aprender de la experiencia ahorraría buena parte del trabajo de programarlo todo al detalle. Según IBM, en 1962, tras miles de partidas contra sí mismo, el programa ganó a un jugador que se presentaba como maestro de damas, Robert Nealey.
¿Cómo aprende una máquina?
Una máquina aprende repitiendo un ciclo sencillo: hace una predicción, la compara con la respuesta correcta, mide cuánto se ha equivocado y ajusta un poco sus valores internos para equivocarse menos. Y vuelve a empezar, miles de veces.
Piensa en alguien que empieza a trabajar en una inmobiliaria y tiene que aprender a calcular el precio de un piso. El primer día da cifras al azar. Cada vez que le dicen el precio real, corrige su intuición: «los metros cuentan más de lo que creía», «la planta baja resta». Al cabo de cientos de pisos, acierta bastante con pisos que nunca ha visto.
Un modelo hace lo mismo, pero con números. Así lo describe el curso de machine learning de Google:
- Empieza con valores casi al azar. Al principio el modelo no sabe nada.
- Calcula el error. Compara sus predicciones con las respuestas reales. A esa medida del error se le llama pérdida.
- Decide hacia dónde moverse. Busca en qué dirección tiene que cambiar sus valores para que el error baje.
- Ajusta un poco. Mueve sus valores un paso pequeño en esa dirección.
- Repite. Vuelve al principio hasta que el error ya no baja más.
En este vocabulario, los datos que usa para predecir (los metros, la planta, el barrio) se llaman características, y la respuesta correcta (el precio) se llama etiqueta. Lo que el modelo guarda al final no son los pisos, sino la «regla» numérica que ha aprendido.
Aprender es equivocarse menos en cada ronda
Animación: un modelo aprende a separar dos grupos de puntos
¿Qué tipos de machine learning hay?
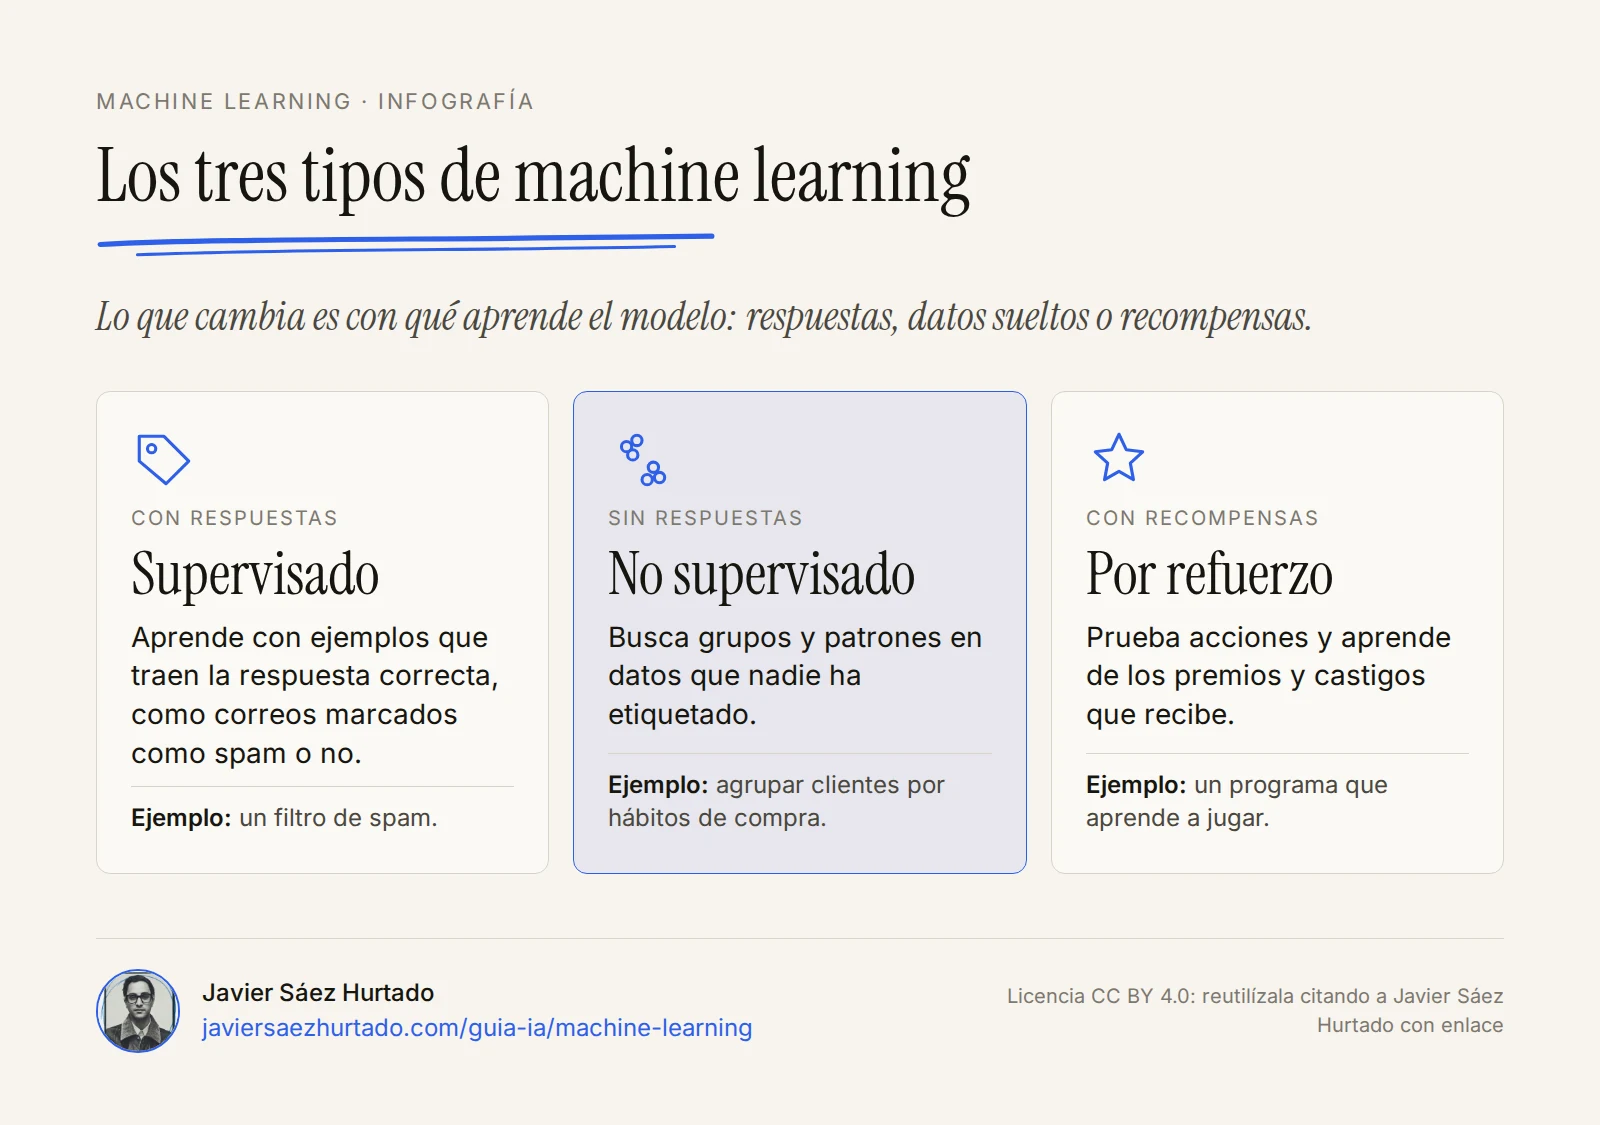
Hay tres tipos principales: el aprendizaje supervisado, que aprende con ejemplos que traen la respuesta; el no supervisado, que busca orden en datos sin respuestas; y el aprendizaje por refuerzo, que aprende probando y recibiendo premios o castigos.
Los tres tipos de machine learning
Con qué aprende cada uno y un ejemplo cotidiano
| Supervisado | No supervisado | Por refuerzo | |
|---|---|---|---|
| Con qué aprende | Ejemplos con la respuesta correcta (datos etiquetados) | Datos sin respuesta | Recompensas y penalizaciones según lo que hace |
| Ejemplo cotidiano | Filtro de spam entrenado con correos marcados como spam o no | Agrupar clientes de una tienda por sus hábitos de compra | Programas que aprenden a jugar, como AlphaGo, o robots que aprenden una tarea |
| Analogía | Estudiar con el solucionario al lado | Ordenar un cajón de fotos sin saber de quién son | Aprender a montar en bici a base de caídas |
El supervisado sirve para clasificar (spam o no spam) y para predecir cifras (lluvia de mañana, precio de un piso). El no supervisado no tiene respuestas que imitar y busca estructura por su cuenta. El aprendizaje por refuerzo aprende por ensayo y error, como un perro al que se premia cuando hace lo que se le pide.
¿Para qué se usa el machine learning en el día a día?
Lo usas casi cada día sin notarlo, sobre todo donde hay muchos datos y escribir las reglas a mano sería imposible:
- Filtro de spam. En 2019, Google explicaba que Gmail bloqueaba más del 99,9 % del spam, el phishing y el malware, y que un nuevo sistema de machine learning le permitía frenar unos 100 millones de correos basura más cada día. El modelo mira miles de señales de cada correo, no una lista fija de palabras.
- Recomendaciones. El clásico «quienes compraron esto también compraron» sale de modelos que encuentran patrones en el historial de compras.
- Detección de fraude. Hay modelos que señalan operaciones que no encajan con el uso habitual de una tarjeta.
- Voz y traducción. El reconocimiento de voz del móvil y los traductores automáticos funcionan con redes neuronales, es decir, con deep learning.
Ejemplo práctico: entrena tu propio modelo sin programar
La mejor forma de entender el entrenamiento es hacerlo una vez. Teachable Machine es una herramienta gratuita de Google que entrena un modelo de imágenes, sonidos o posturas desde el navegador, sin escribir código. Según Google, los ejemplos y el entrenamiento se quedan en tu ordenador salvo que decidas guardar el proyecto en Google Drive.
Vamos a enseñarle a distinguir si sostienes una taza o no:
- Abre teachablemachine.withgoogle.com y crea un proyecto de imágenes.
- Define dos clases. Llama a una «Con taza» y a otra «Sin taza». Esas son tus etiquetas.
- Reúne ejemplos. Con la cámara, graba unas cien imágenes de cada clase. Mueve la taza, cambia de mano, acércate y aléjate.
- Entrena. Pulsa el botón de entrenar. Mientras esperas, el modelo está repitiendo el ciclo de predecir, medir el error y ajustar.
- Prueba. En la vista previa, ponte delante de la cámara con y sin taza: el modelo te irá diciendo en tiempo real qué clase cree que ve.
Ahora cambia de habitación, apaga una luz o enseña un vaso en lugar de una taza. Es muy probable que el modelo dude o se equivoque. No ha aprendido qué es una taza: ha aprendido qué diferencia tus imágenes de un lado y del otro. Con ejemplos más variados y un nuevo entrenamiento, mejora. Acabas de ver el límite más importante del machine learning.
¿Qué límites tiene el machine learning?
El machine learning solo aprende lo que hay en sus datos. Si los datos son pocos, parciales o reflejan injusticias del pasado, el modelo aprende esos defectos y los repite con total seguridad.
- Calidad y variedad de los datos. Google insiste en que un buen conjunto de datos es a la vez grande y variado. Cien fotos de la misma taza con la misma luz enseñan poco.
- Sesgos. Google describe varios tipos. Uno es el sesgo de lo que se registra: un modelo entrenado con reseñas de libros tiende a los extremos, porque casi nadie escribe una reseña de un libro que le dejó indiferente. Otro es el sesgo histórico: los datos de décadas pasadas pueden incluir discriminaciones que el modelo aprende como si fueran normales.
- Sobreajuste. Ocurre cuando el modelo memoriza los ejemplos de entrenamiento en lugar de aprender la regla general, y falla con casos nuevos. Es como el estudiante que memoriza los exámenes de otros años y suspende en cuanto cambian las preguntas. Google lo compara con un invento que funciona en el laboratorio y no en el mundo real.
Por eso, como explica la documentación de scikit-learn, lo básico es separar los datos en dos partes: una para entrenar y otra, que el modelo no ha visto, para comprobar si de verdad ha aprendido. Y un límite de fondo: un modelo da probabilidades, no certezas, y puede equivocarse con mucha confianza.
¿Qué tiene que ver el machine learning con ChatGPT y los LLM?
Los modelos de lenguaje grandes, o LLM, que hay detrás de ChatGPT, Claude o Gemini son machine learning: redes neuronales con miles de millones de valores ajustados durante el entrenamiento. Cambia la escala, no el principio.
Su entrenamiento mezcla varias de las ideas que has visto. Primero aprenden de enormes cantidades de texto a predecir las palabras que faltan o la que viene después. Se le llama aprendizaje autosupervisado, porque el propio texto hace de respuesta correcta. Después, en el método que OpenAI describió en 2022 con InstructGPT, se ajustan con ejemplos escritos por personas (aprendizaje supervisado) y con aprendizaje por refuerzo a partir de cómo valoran las personas sus respuestas. Se explica paso a paso en la lección sobre qué es un LLM.
Por eso un LLM también puede sobreajustarse, heredar los sesgos de sus textos o equivocarse con seguridad, porque genera lo probable según sus datos, no lo comprobado.
Lo que yo tendría en cuenta
Ante cualquier sistema que «aprende», yo miraría primero los datos con los que aprendió, antes que el algoritmo. Si no sé de dónde salen ni qué casos dejan fuera, no sé dónde va a fallar.
También desconfiaría de un modelo que solo he visto funcionar en una demostración. Como en el ejemplo de la taza, lo que importa es cómo se comporta con casos nuevos, y eso solo se sabe probándolo con trabajo real. Y cuando la predicción decide algo difícil de deshacer o que afecta a personas, la última palabra la debería tener una persona. Es el mismo criterio que aplico a los agentes en qué le dejarías hacer a un agente sin mirar.
Lo que conviene recordar
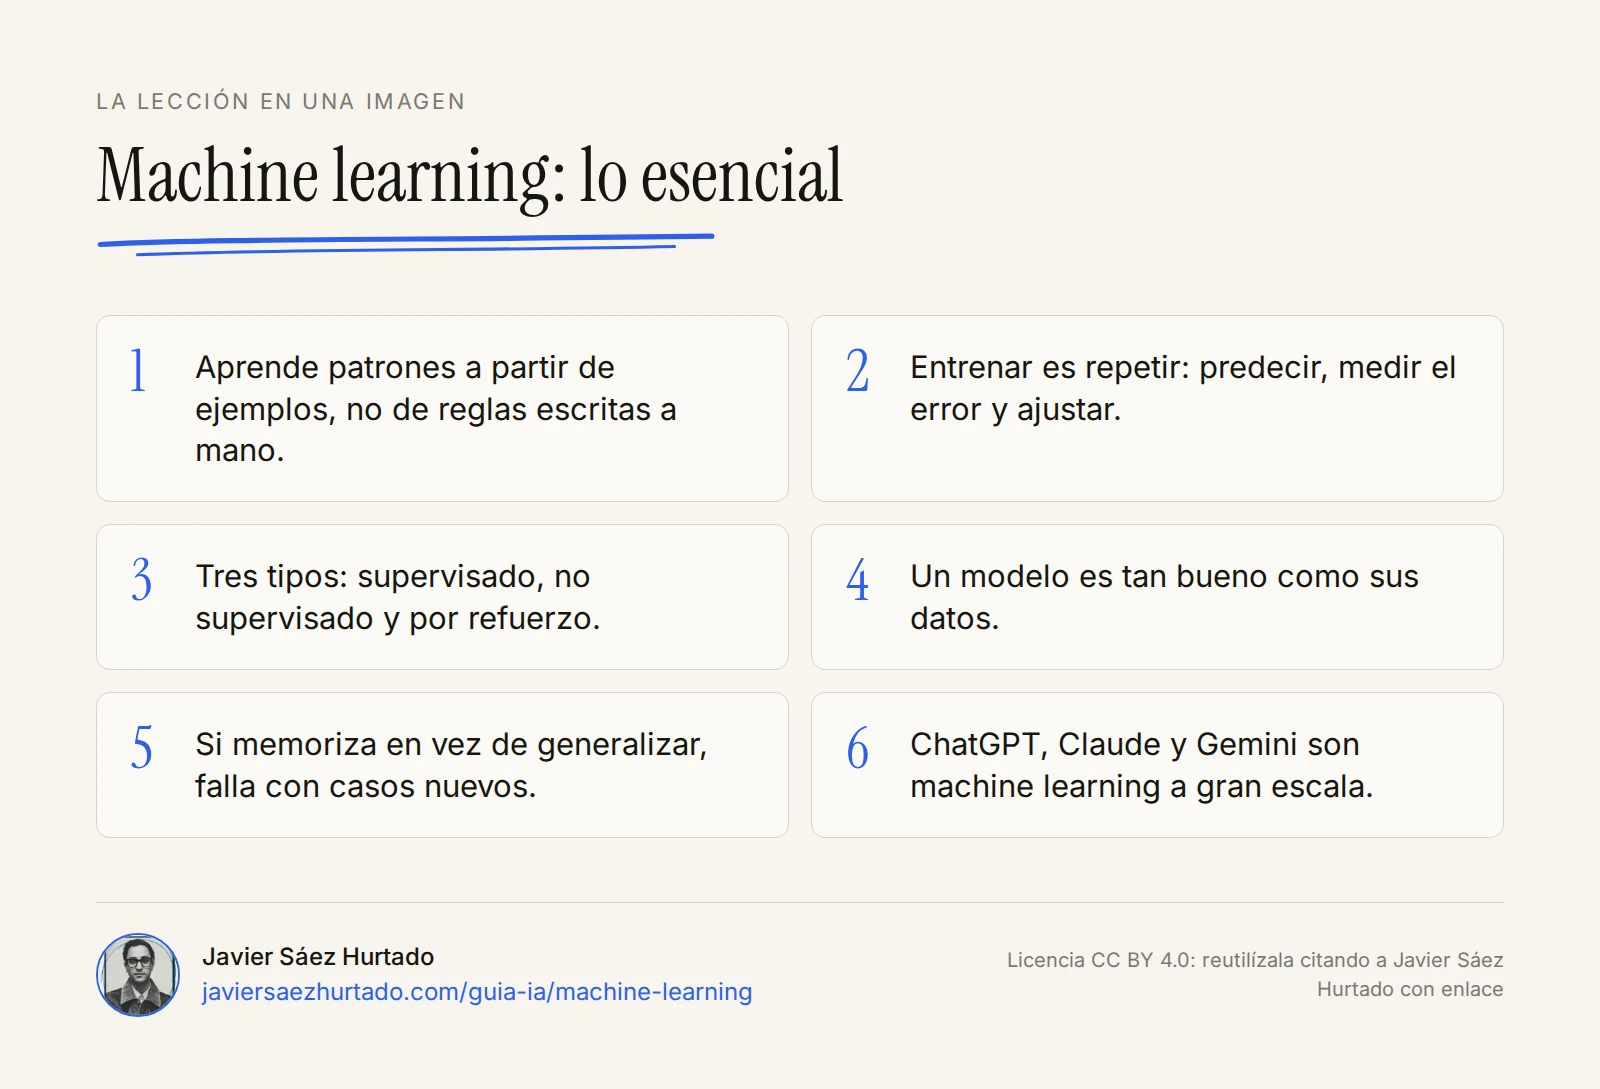
- El machine learning es la parte de la IA en la que el sistema aprende patrones de los datos en lugar de seguir reglas escritas a mano.
- Entrenar es repetir un ciclo: predecir, medir el error y ajustar un poco, miles de veces.
- Hay tres tipos principales: supervisado (con respuestas), no supervisado (sin respuestas) y por refuerzo (con recompensas).
- Un modelo es tan bueno como sus datos: los sesgos y la falta de variedad se aprenden, y el sobreajuste hace que falle con casos nuevos.
- ChatGPT, Claude y Gemini son machine learning a gran escala, y por eso comparten sus mismos límites.
La lección en una imagen
Preguntas frecuentes
¿Qué es el machine learning en palabras sencillas?
Es una forma de programar en la que, en lugar de escribir las reglas, se le dan al ordenador muchos ejemplos y él encuentra los patrones. Con esos patrones puede hacer predicciones sobre casos nuevos, como decidir si un correo es spam.
¿Es lo mismo machine learning que inteligencia artificial?
No. La inteligencia artificial es el campo general y el machine learning es una de sus partes: todo el machine learning es IA, pero no toda la IA es machine learning. Un termostato que sigue una regla fija hace algo automático, pero no aprende de datos.
¿Qué diferencia hay entre machine learning y deep learning?
El deep learning es un tipo de machine learning que usa redes neuronales con muchas capas. Es el enfoque que domina hoy en lenguaje, imagen y voz, mientras que el machine learning incluye también métodos más sencillos.
¿Cuáles son los tipos de aprendizaje automático?
Los tres principales son el aprendizaje supervisado, que aprende con ejemplos que traen la respuesta correcta; el no supervisado, que busca grupos o patrones en datos sin respuestas; y el aprendizaje por refuerzo, que aprende probando acciones y recibiendo recompensas o penalizaciones.
¿Hace falta saber programar para entender el machine learning?
Para entender cómo funciona, no. Herramientas gratuitas como Teachable Machine de Google permiten entrenar un modelo de imágenes desde el navegador con la cámara. Para construir sistemas reales sí hace falta programar y saber de datos y estadística.
¿ChatGPT es machine learning?
Sí. ChatGPT, Claude o Gemini funcionan con modelos de lenguaje grandes, que son redes neuronales entrenadas con enormes cantidades de texto. Después suelen ajustarse con ejemplos escritos por personas y con aprendizaje por refuerzo a partir de valoraciones humanas, un método que OpenAI describió en 2022.
Fuentes
- Google for Developers, What is Machine Learning? (Introduction to Machine Learning)
- Google for Developers, Supervised Learning (Introduction to Machine Learning)
- Google Machine Learning Crash Course, Linear regression: Gradient descent
- Google Machine Learning Crash Course, Overfitting
- Google Machine Learning Crash Course, Fairness: Types of bias
- Google Machine Learning Crash Course, LLMs: What's a large language model?
- IBM, What is machine learning?
- IBM, Types of machine learning
- IBM, The games that helped AI evolve
- Arthur L. Samuel, Some Studies in Machine Learning Using the Game of Checkers, IBM Journal of Research and Development (1959)
- scikit-learn, An introduction to machine learning with scikit-learn
- Google Workspace, Ridding Gmail of 100 million more spam messages with TensorFlow (7 feb 2019)
- Google, Teachable Machine 2.0 makes AI easier for everyone (7 nov 2019)
- Ouyang et al., Training language models to follow instructions with human feedback (arXiv, 2022)