Guía de estudio de IA · Módulo 1. Fundamentos
Qué es un LLM (modelo de lenguaje grande) y cómo funciona
Un LLM (modelo de lenguaje grande) es un programa entrenado con enormes cantidades de texto para predecir, pieza a pieza, cómo sigue un texto. Esa idea sencilla está detrás de ChatGPT, Claude o Gemini, y también explica su principal límite: escribe lo probable, no lo comprobado.
¿Qué es un LLM?
LLM son las siglas en inglés de large language model, «modelo de lenguaje grande». Es un programa entrenado con enormes cantidades de texto para hacer, en el fondo, una sola cosa: calcular qué trozo de texto es más probable que venga a continuación.
Es la tecnología que hay detrás de ChatGPT, Claude, Gemini o DeepSeek. IBM lo define como un tipo de modelo de deep learning entrenado con cantidades inmensas de datos, capaz de entender y generar lenguaje para tareas muy distintas.
Lo de «grande» se refiere a la cantidad de texto con la que aprende y al número de parámetros, los valores internos que ajusta al entrenarse. Según el curso de machine learning de Google, los mayores tienen cientos de miles de millones de parámetros, o incluso billones.
¿Cómo funciona un LLM?
Un LLM funciona prediciendo el siguiente trozo de texto, una y otra vez. Recibe tu mensaje, calcula qué pieza encaja mejor después, la añade y repite hasta completar la respuesta.
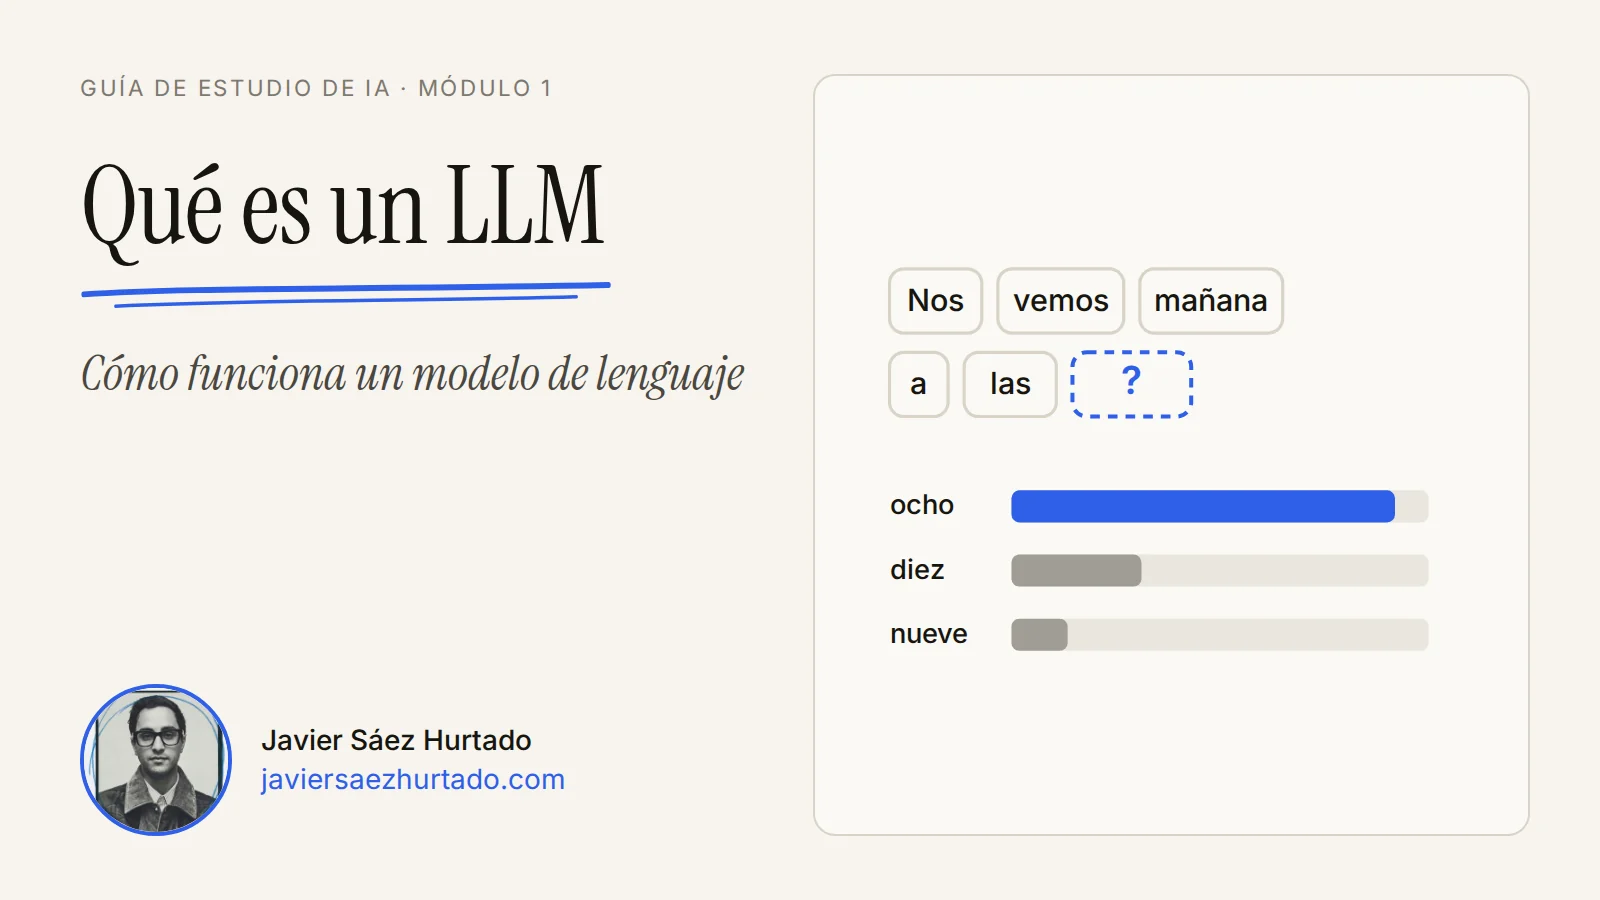
La mejor analogía es el autocompletado del teclado del móvil. Escribes «nos vemos mañana a las» y el teclado te sugiere «ocho» o «diez». Un LLM hace lo mismo con muchísimo más contexto y entrenamiento. El curso de Google usa la misma comparación: un mecanismo de autocompletado capaz de predecir miles de tokens seguidos.
El modelo no elige a ciegas: reparte probabilidades. En un ejemplo de ese curso, ante una frase en inglés que vendría a ser «cuando oigo la lluvia en el tejado, yo ___ en mi cocina», da un 9,4 % a «hago sopa» y un 5,2 % a «caliento una tetera». La aplicación puede quedarse con la opción más probable o elegir al azar entre las mejores. Por eso la misma pregunta no siempre recibe la misma respuesta.
¿Cómo puede algo tan simple ser útil? Porque para predecir bien la siguiente palabra en miles de millones de frases no basta con memorizar. El modelo acaba captando gramática, estilo, datos sobre el mundo y patrones de razonamiento. Pero sigue siendo una predicción: escribe lo que suena probable, no lo que ha comprobado.
Un modelo de lenguaje escribe token a token
Interactivo: pide el siguiente token y cambia la temperatura
Tu mensaje y lo que el modelo va escribiendo
Nosvemosmañanaalas
Candidatos para el siguiente token
¿Qué son los tokens?
Un token es la unidad en la que un LLM trocea el texto: una palabra, un trozo de palabra o un signo. Sus límites y sus precios se miden en tokens.
Así parte unas frases o200k_base, el tokenizador que OpenAI publica en su librería tiktoken para modelos como GPT-4o y GPT-5:
Cómo se convierte una frase en tokens
Cada barra separa un token. Los espacios van pegados al principio del token siguiente
| Cómo se parte | Palabras | Tokens | |
|---|---|---|---|
| Los gatos duermen mucho. | Los | gatos | du | ermen | mucho | . | 4 | 6 |
| Mañana llueve en Andorra. | M | añ | ana | ll | ueve | en | And | orra | . | 4 | 9 |
| The cats sleep a lot. | The | cats | sleep | a | lot | . | 5 | 6 |
Las palabras frecuentes suelen ser un solo token («gatos», «mucho»); las menos habituales se parten («du» y «ermen»). OpenAI da una regla aproximada para el inglés: un token son unos 4 caracteres, y 100 tokens, unas 75 palabras. También avisa de que en otros idiomas la relación cambia. En los ejemplos de arriba, el español gasta algo más de tokens por palabra.
¿Cómo se entrena un modelo de lenguaje?
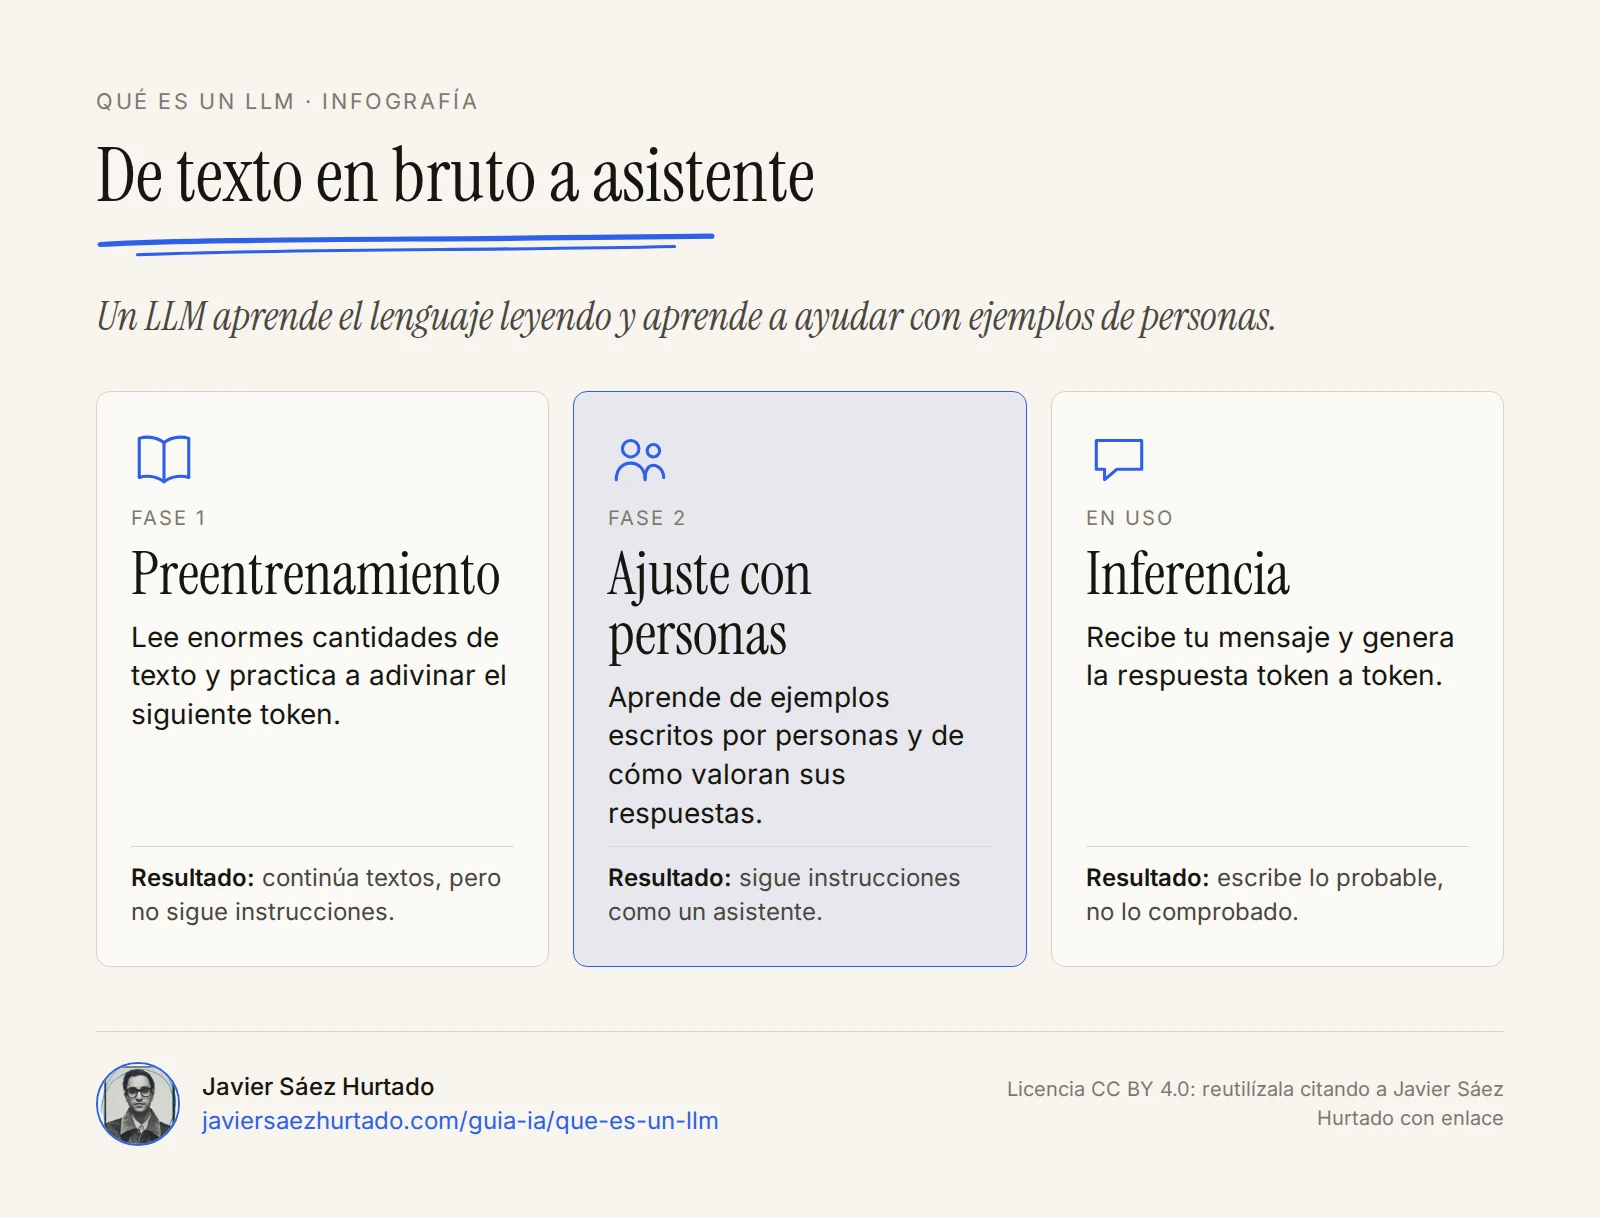
Un LLM se entrena en dos grandes fases. Primero aprende el lenguaje leyendo muchísimo texto; después aprende a ser un asistente útil con ejemplos y valoraciones de personas.
La primera fase es el preentrenamiento: el modelo lee miles de millones de palabras y practica a adivinar el siguiente token. Nadie etiqueta nada, porque la respuesta está en el propio texto. IBM lo llama aprendizaje autosupervisado.
El resultado continúa textos muy bien, pero no sigue instrucciones. El artículo de OpenAI sobre InstructGPT, de marzo de 2022, describe la segunda fase en tres pasos:
- Ajuste supervisado. Personas escriben ejemplos de buenas respuestas y el modelo aprende de ellos, igual que en el aprendizaje supervisado clásico.
- Modelo de recompensa. Personas ordenan varias respuestas de mejor a peor y con eso se entrena otro modelo que aprende a puntuarlas.
- Aprendizaje por refuerzo con retroalimentación humana (RLHF). El modelo practica para conseguir mejores puntuaciones.
El efecto fue llamativo: los evaluadores prefirieron las respuestas de un InstructGPT de 1.300 millones de parámetros a las de GPT-3, con 175.000 millones. Además era más veraz y menos tóxico, aunque seguía cometiendo errores simples. Las técnicas han evolucionado, pero las dos fases siguen siendo la base.
¿Qué es un transformer y por qué importa la atención?
El transformer es la arquitectura de red neuronal en la que se basan los LLM actuales. La presentó en 2017 un equipo de investigadores, casi todos de Google, en el artículo «Attention Is All You Need». Su idea central es la atención: cada pieza del texto mira a las demás para decidir cuáles le importan.
Antes, los modelos de lenguaje más usados leían token a token y les costaba recordar lo que había aparecido mucho antes. El transformer se apoyó solo en la atención, así que podía procesar el texto en paralelo y entrenarse mucho más deprisa. En el artículo original logró resultados punteros en traducción tras 3,5 días de entrenamiento con ocho GPU.
Un ejemplo del curso de Google ayuda a verlo. En «el animal no cruzó la calle porque estaba demasiado cansado», para saber quién estaba cansado hay que relacionar «cansado» con «animal» y no con «calle». La atención calcula esas relaciones entre todas las palabras, aunque estén lejos. La «T» de GPT viene de ahí: generative pre-trained transformer.
¿Qué es la ventana de contexto?
La ventana de contexto es todo el texto que un modelo puede tener en cuenta a la vez al generar una respuesta, incluida la propia respuesta. Anthropic la describe como una memoria de trabajo, distinta del texto con el que el modelo se entrenó.
Ahí entra todo: tus mensajes, los documentos que adjuntas, las instrucciones de la aplicación y lo que el modelo va escribiendo. Lo que no cabe, el modelo no lo ve. Según Anthropic, sus modelos de Claude más recientes tienen una ventana de un millón de tokens, y otros, de 200.000.
Más grande no siempre es mejor. Anthropic advierte que, cuanto más se llena, más precisión pierde el modelo, un fenómeno que llama context rot. Por eso importa tanto qué metes en la ventana como su tamaño: si cambias de tema, suele compensar abrir una conversación nueva.
¿Por qué un LLM se inventa cosas?
Un LLM se inventa cosas porque está entrenado para producir texto probable, no para comprobar si es verdad. A esas respuestas falsas que suenan convincentes se las llama alucinaciones.
OpenAI dio en septiembre de 2025 dos motivos. En el preentrenamiento no hay etiquetas de verdadero o falso, y hay datos, como el cumpleaños de una persona, que no siguen ningún patrón deducible. Y las evaluaciones que solo puntúan aciertos premian adivinar: decir una fecha al azar da una posibilidad entre 365, y decir «no lo sé», cero puntos seguros.
El riesgo es mayor justo donde más duele: nombres, fechas, cifras, citas y referencias. Las defensas más útiles son darle al modelo el documento en lugar de preguntarle de memoria, permitirle decir que no sabe y comprobar en la fuente cualquier dato que vayas a usar.
¿Qué LLM existen hoy?
Los más conocidos son GPT (OpenAI), Claude (Anthropic) y Gemini (Google). Junto a ellos hay familias cuyos pesos se pueden descargar y usar en equipos propios, como Llama, Mistral o DeepSeek.
Algunas familias de LLM a octubre de 2026
Quién las desarrolla y cómo se usan
| Desarrolla | Cómo se usa | |
|---|---|---|
| GPT | OpenAI | En ChatGPT y en la API de OpenAI |
| Claude | Anthropic | En la aplicación de Claude y en su API |
| Gemini | En la aplicación de Gemini y en la API de Google | |
| Llama | Meta | Pesos descargables con licencia propia |
| Mistral | Mistral AI | Pesos descargables; Mistral 3 se publicó con licencia Apache 2.0 |
| DeepSeek | DeepSeek (China) | En su aplicación y con pesos descargables con licencia MIT |
Para las novedades, mejor ir a artículos con fecha, como el de GPT-6 Astra, de OpenAI.
¿Es lo mismo ChatGPT que GPT?
No. GPT es la familia de modelos de lenguaje de OpenAI; ChatGPT es la aplicación, lanzada el 30 de noviembre de 2022, con la que la mayoría de la gente los usa.
La aplicación pone la interfaz, el historial, sus propias instrucciones y herramientas como la búsqueda. El modelo es quien genera el texto. DeepSeek lo deja aún más claro: su aplicación es de código cerrado, pero sus modelos se publican con licencia MIT.
La distinción importa. Dos aplicaciones con el mismo modelo pueden comportarse distinto, porque cada una añade sus instrucciones y herramientas. Y cuando un modelo usa herramientas para actuar en varios pasos, ya no hablamos de un chat, sino de un agente de IA.
Ejemplo práctico: cómo comprobar una respuesta de un LLM
Primero, pregunta algo concreto y dale permiso para no saber:
¿En qué año se publicó el artículo que presentó la arquitectura transformer y quién lo firmó? Si no estás seguro de algún dato, dilo en lugar de suponerlo. Indica de dónde sale cada dato, con enlace.
Después, abre cada enlace y comprueba que existe y que dice lo que la respuesta afirma. La respuesta correcta es 2017, «Attention Is All You Need», de Ashish Vaswani y otros siete autores, en arXiv con el número 1706.03762.
La versión más fiable es darle tú la fuente, para que responda con lo que tiene en su ventana de contexto y no con lo que recuerda:
Responde solo con la información del texto que pego abajo. Si la respuesta no está en el texto, escribe «no aparece en el texto». Cita la frase exacta en la que te basas.

[pega aquí el texto]
Pedir la frase exacta te permite comprobar en segundos si está de verdad en el documento. En la lección sobre qué es un prompt hay más formas de pedir las cosas.
¿Qué límites tienen los LLM?
Son muy útiles para escribir, resumir o traducir, pero hay límites que no desaparecen con un modelo más nuevo:
- Alucinan. Dicen lo falso con la misma seguridad que lo cierto.
- Su conocimiento tiene fecha. Saben lo que había en sus datos de entrenamiento; lo posterior solo lo conocen si se lo das o si la aplicación lo busca.
- Su memoria de trabajo es finita. Lo que no cabe en la ventana de contexto no existe para el modelo.
- Heredan sesgos. Google e IBM advierten que pueden reproducir, e incluso amplificar, los sesgos de sus datos.
Lo que yo tendría en cuenta
Esta guía la preparo con ayuda de IA, como explico al pie de cada lección. Precisamente por eso cito la fuente de cada dato, y nada de lo que sale en mi nombre se publica sin que lo revise yo.
Mi regla es sencilla: cuanto más caro sea equivocarse, más hay que comprobar. Para una lluvia de ideas, lo que diga el modelo basta. Para una cifra, una cita o un texto que va a leer otra persona, no.
Lo que conviene recordar
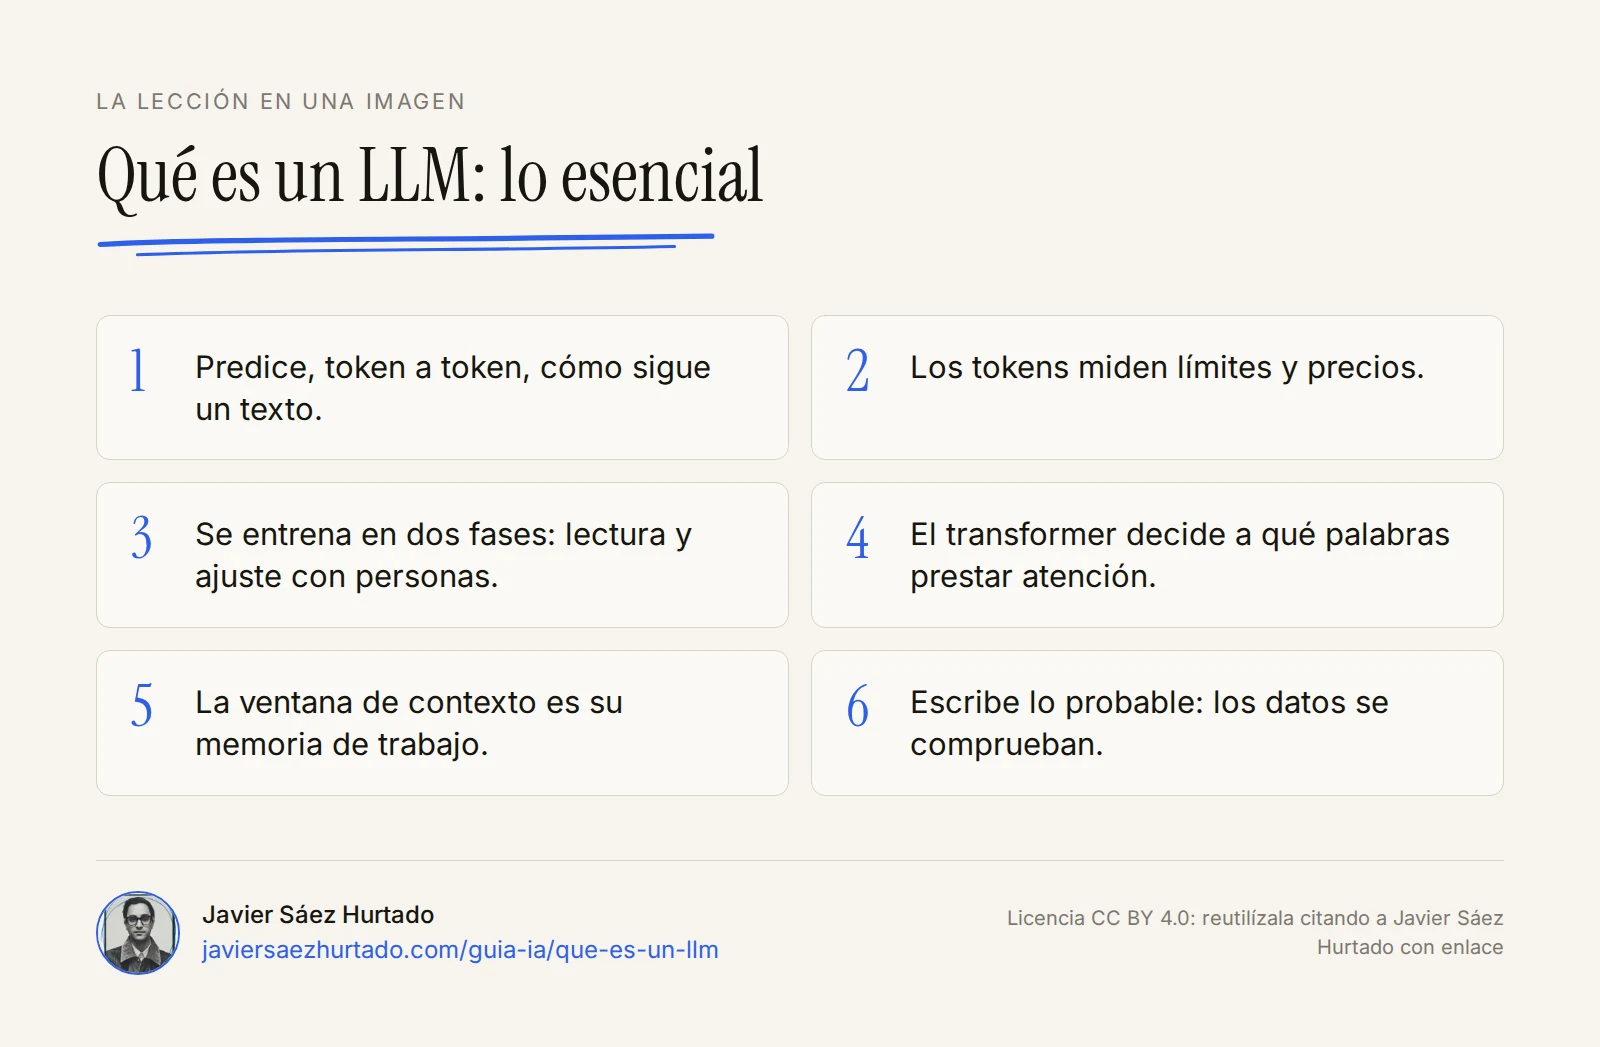
- Un LLM es un modelo entrenado con enormes cantidades de texto que predice, token a token, cómo sigue un texto.
- Los tokens son las piezas en las que trocea el texto; los límites y los precios se miden en ellos.
- Se entrena en dos fases: preentrenamiento con mucho texto y ajuste con ejemplos y valoraciones de personas.
- La ventana de contexto es su memoria de trabajo: conviene llenarla con lo justo y relevante.
- Escribe lo probable, no lo comprobado: los datos que vayas a usar, compruébalos siempre en la fuente.
La lección en una imagen
Preguntas frecuentes
¿Qué significa LLM?
LLM son las siglas en inglés de large language model, «modelo de lenguaje grande». Es un modelo de inteligencia artificial entrenado con enormes cantidades de texto para predecir cómo sigue un texto, y es la tecnología que hay detrás de asistentes como ChatGPT, Claude o Gemini.
¿ChatGPT es un LLM?
No exactamente. ChatGPT es una aplicación de OpenAI; los LLM que la hacen funcionar son los modelos GPT. La aplicación añade la interfaz, el historial y herramientas como la búsqueda, pero quien genera el texto es el modelo.
¿Qué es un token en inteligencia artificial?
Un token es la unidad en la que un modelo de lenguaje divide el texto: una palabra, un trozo de palabra o un signo de puntuación. Según OpenAI, en inglés un token equivale de media a unos 4 caracteres, y los límites y los precios de los modelos se miden en tokens.
¿Qué es la ventana de contexto de un LLM?
Es todo el texto que el modelo puede tener en cuenta a la vez al generar una respuesta, incluida la propia respuesta. Funciona como una memoria de trabajo: lo que queda fuera no lo ve, y cuanto más se llena, más le cuesta encontrar lo importante.
¿Por qué ChatGPT y otros LLM se inventan cosas?
Porque generan el texto más probable, no el comprobado. OpenAI explica que, además, muchas evaluaciones premian acertar por intuición en lugar de reconocer que no se sabe algo. Por eso conviene pedir fuentes y comprobarlas.
¿Un LLM busca en internet?
El modelo por sí solo no: responde con lo que aprendió al entrenarse y con lo que tiene en su ventana de contexto. Algunas aplicaciones le añaden herramientas de búsqueda, y entonces lo que encuentra pasa a su contexto antes de responder.
Fuentes
- Vaswani et al., Attention Is All You Need (arXiv 1706.03762, 2017)
- Ouyang et al., Training language models to follow instructions with human feedback (arXiv 2203.02155, 2022)
- OpenAI, What are tokens and how to count them? (centro de ayuda)
- OpenAI, tiktoken (repositorio oficial del tokenizador)
- OpenAI, Why language models hallucinate (5 sep 2025)
- Anthropic, Context windows (documentación de Claude)
- Google, Machine Learning Crash Course: What is a language model?
- Google, Machine Learning Crash Course: What's a large language model?
- IBM, What are large language models (LLMs)?
- Mistral AI, Introducing Mistral 3 (2 dic 2025)
- Wikipedia, ChatGPT
- Wikipedia, Claude (language model)
- Wikipedia, Google Gemini
- Wikipedia, Llama (language model)
- Wikipedia, DeepSeek (chatbot)